ESTATÍSTICA E PROBABILIDADE P/ COMPUTAÇÃO
Referências da disciplina:
Probabilidade
Conceitos de probabilidade
Existem diferentes formas de interpretar o que significa "probabilidade":
-
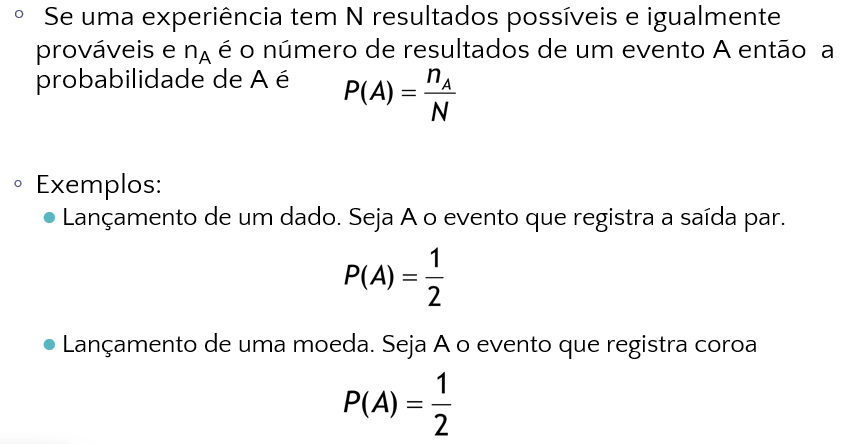
Clássico — baseado em espaços amostrais com resultados igualmente prováveis.
Imagem de referência
-
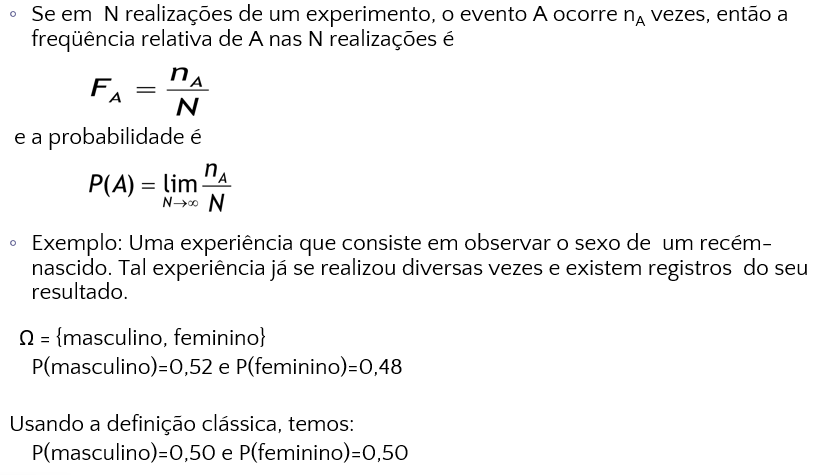
Frequentista — baseado na frequência relativa observada em repetições do experimento.
Imagem de referência
-
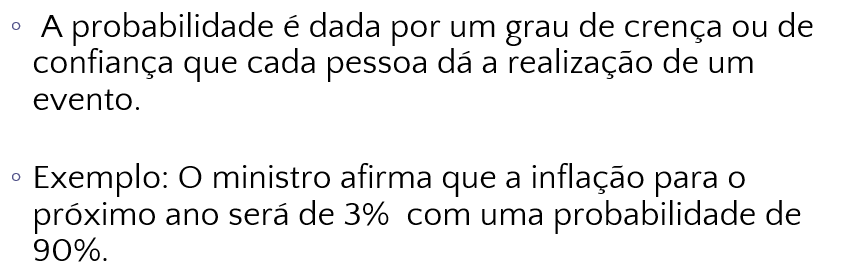
Subjetivo — baseado no grau de crença pessoal sobre a ocorrência de um evento.
Imagem de referência
-
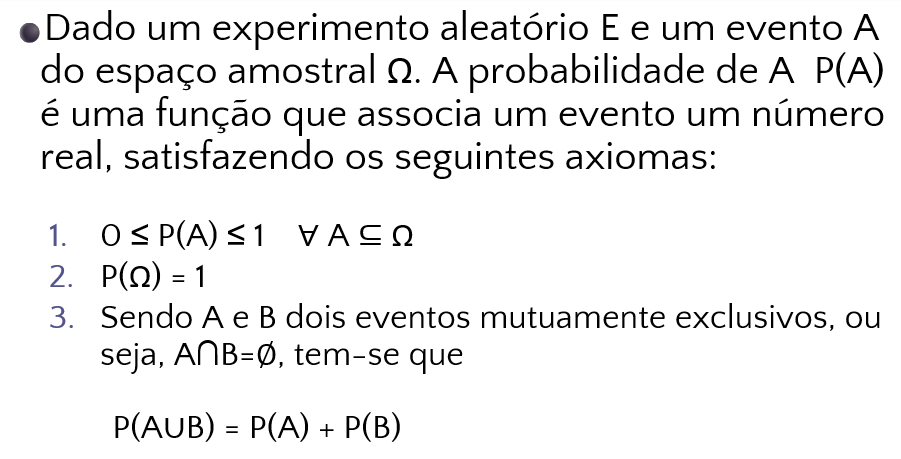
Formal (axiomático) — baseado nos axiomas de Kolmogorov, que fundamentam matematicamente a probabilidade independentemente de interpretação.
Imagem de referência
Experimento aleatório
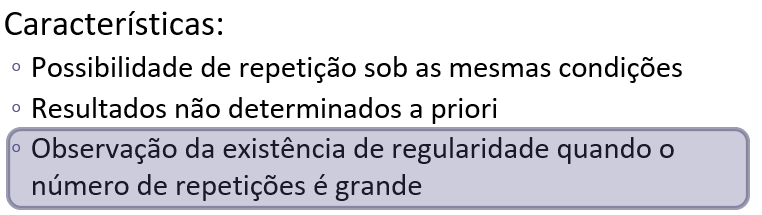
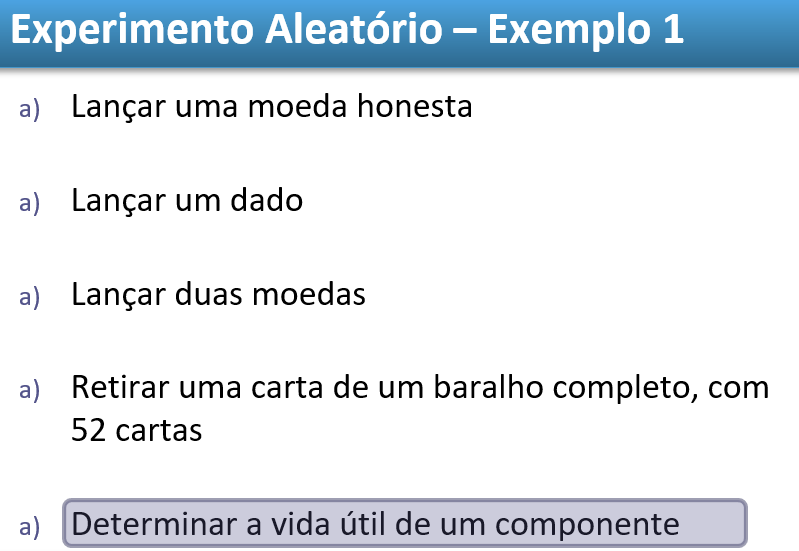
Um experimento aleatório é aquele em que há possibilidade de ocorrência de diversos resultados (eventos), sem que se possa prever com certeza qual deles vai ocorrer.
Imagem de referência
Example
Imagem de referência
Espaço amostral
O espaço amostral (\(\Omega\)) é o conjunto de todos os resultados possíveis de um experimento. Um resultado do espaço amostral é chamado de evento. \(\Omega\) pode ser:
-
Quantitativo — abordagem numérica para a coleta de dados.
-
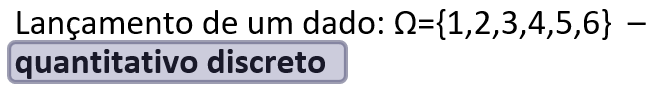
Discreto — resulta de um conjunto finito (ou enumerável) de valores possíveis.
Example
Imagem de referência
-
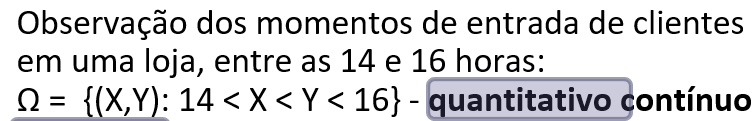
Contínuo — resulta de um número infinito de valores possíveis, associados a pontos de uma escala contínua.
Example
Imagem de referência
-
-
Qualitativo — abordagem não numérica para a coleta de dados.
Example
Imagem de referência
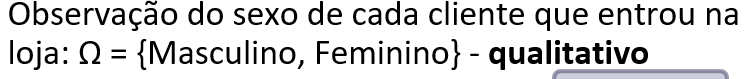
Exemplos de espaço amostral
Imagens de referência
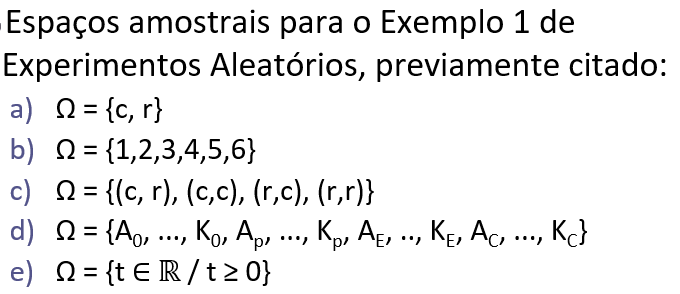
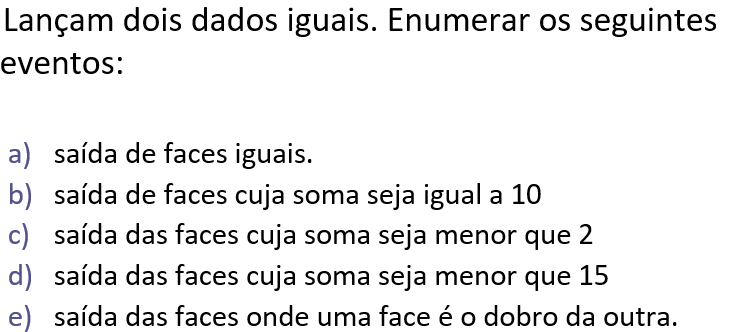
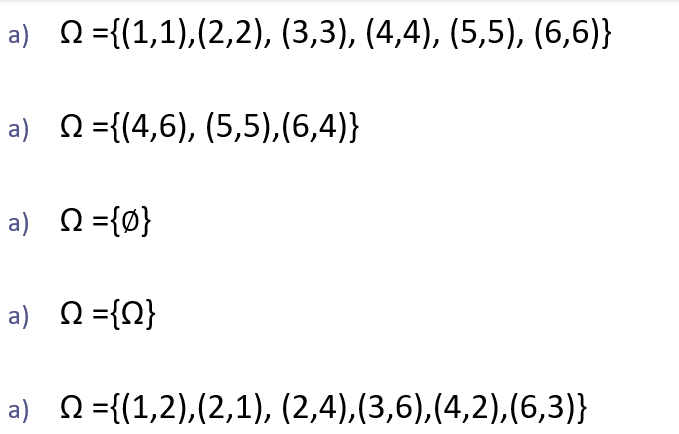
Classe de eventos aleatórios
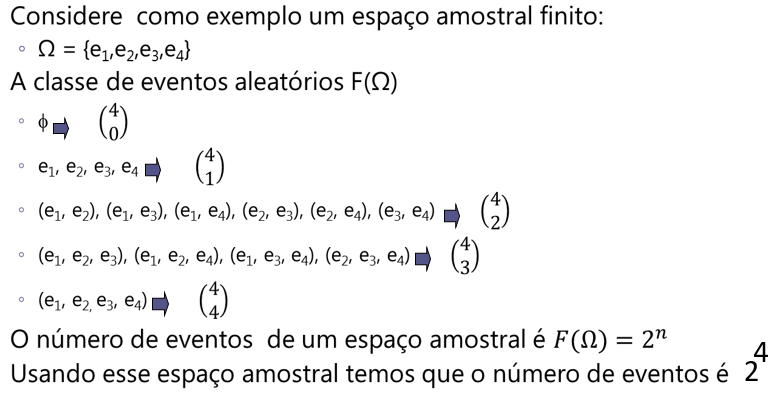
A classe de eventos aleatórios é o conjunto de todos os subconjuntos (eventos) do espaço amostral — ou seja, o conjunto das partes de \(\Omega\).
Imagem de referência
Propriedades
Imagem de referência
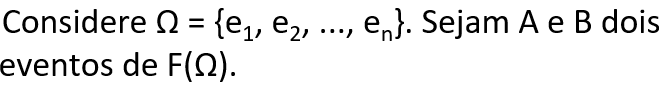
Operações sobre eventos
-
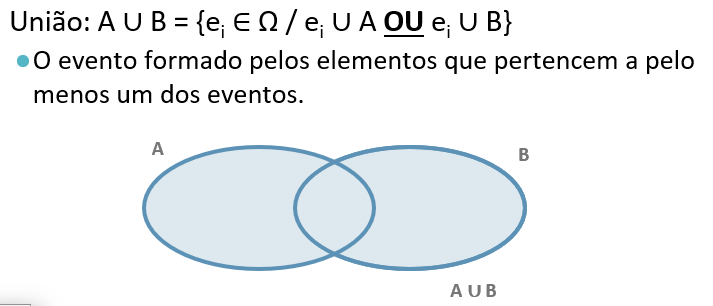
União (\(A \cup B\)):
Imagem de referência
-
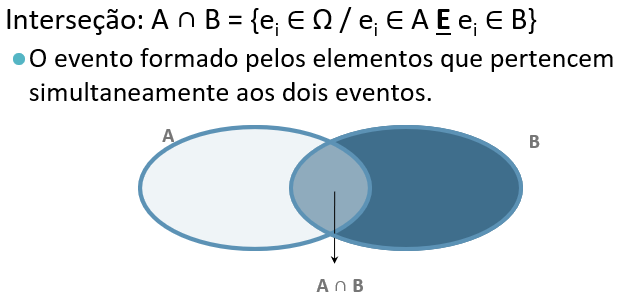
Interseção (\(A \cap B\)):
Imagem de referência
-
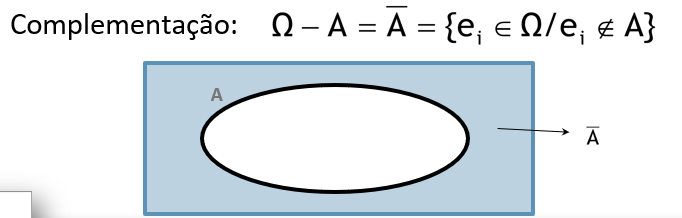
Complementação (\(A^c\) ou \(\overline{A}\)):
Imagem de referência
Example
Imagens de referência
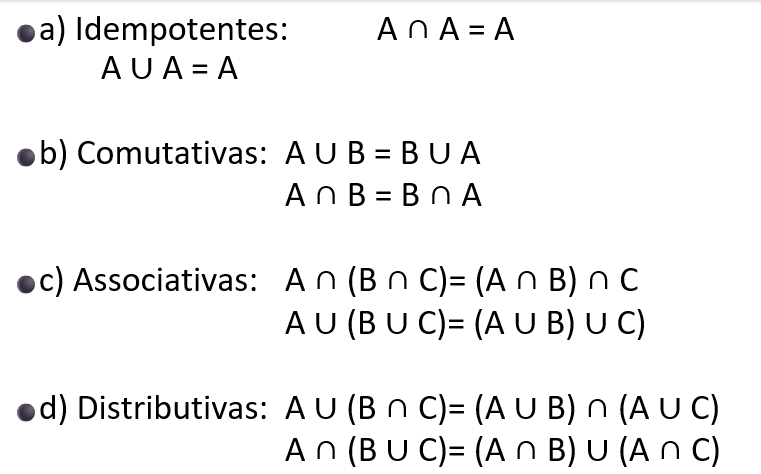
Propriedades das operações
Imagens de referência
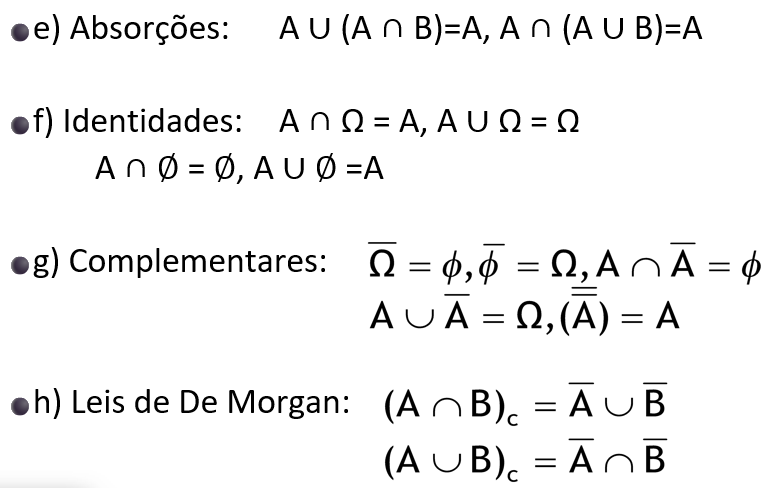
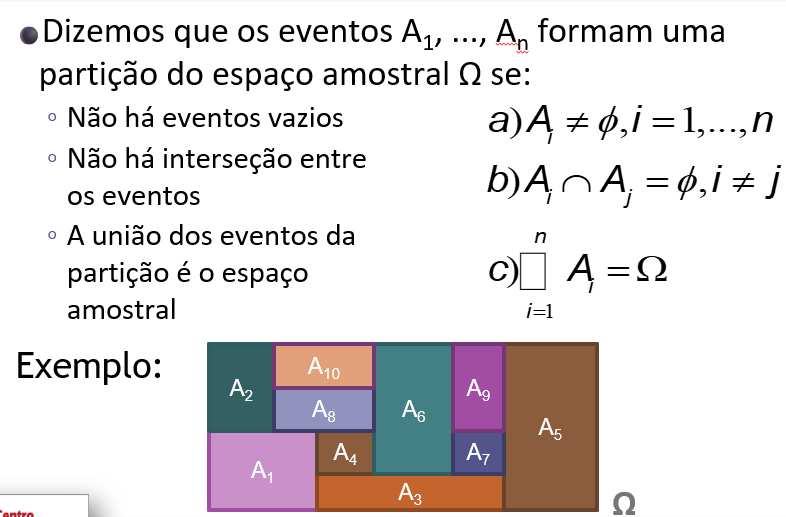
Partição
Uma partição do espaço amostral é uma coleção de eventos mutuamente exclusivos cuja união é o próprio \(\Omega\).
Imagem de referência
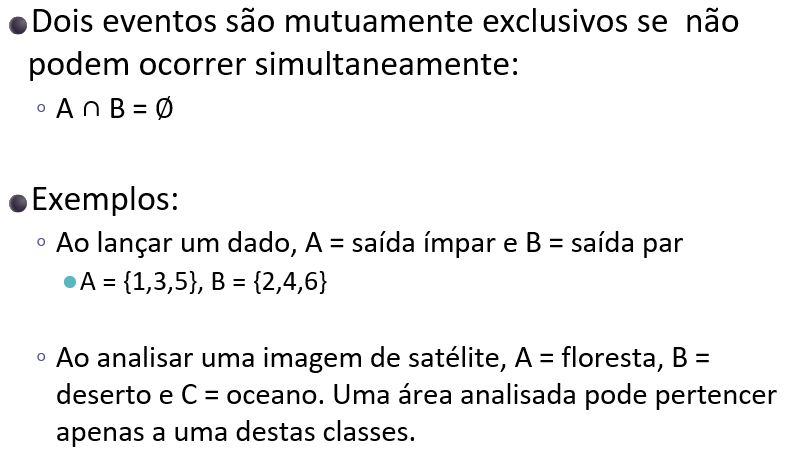
Eventos mutuamente exclusivos
Dois eventos são mutuamente exclusivos (ou disjuntos) quando não podem ocorrer simultaneamente, isto é, \(A \cap B = \emptyset\).
Imagem de referência
Experimentos de contagem
Técnicas de contagem (análise combinatória) são usadas para calcular o número de resultados possíveis em experimentos complexos, essencial para calcular probabilidades no conceito clássico.
Imagem de referência
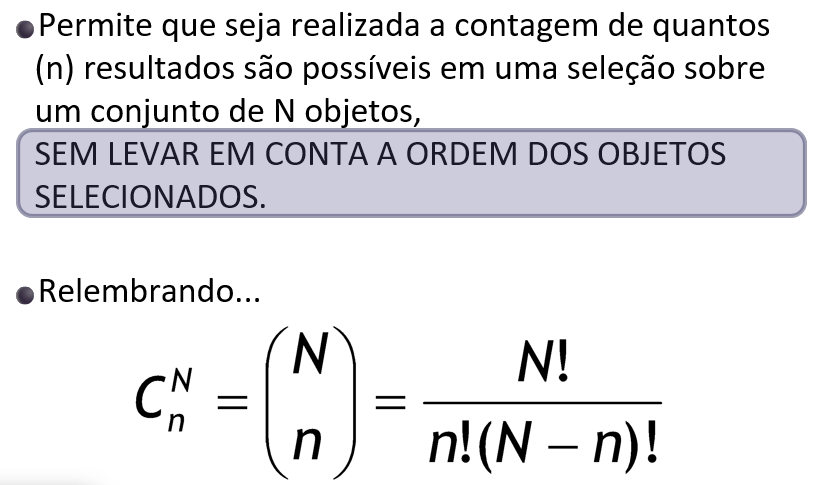
Combinação — escolha de \(k\) elementos de um conjunto de \(n\), sem considerar a ordem: \(\binom{n}{k} = \dfrac{n!}{k!(n-k)!}\).
Imagem de referência
Example
Imagens de referência
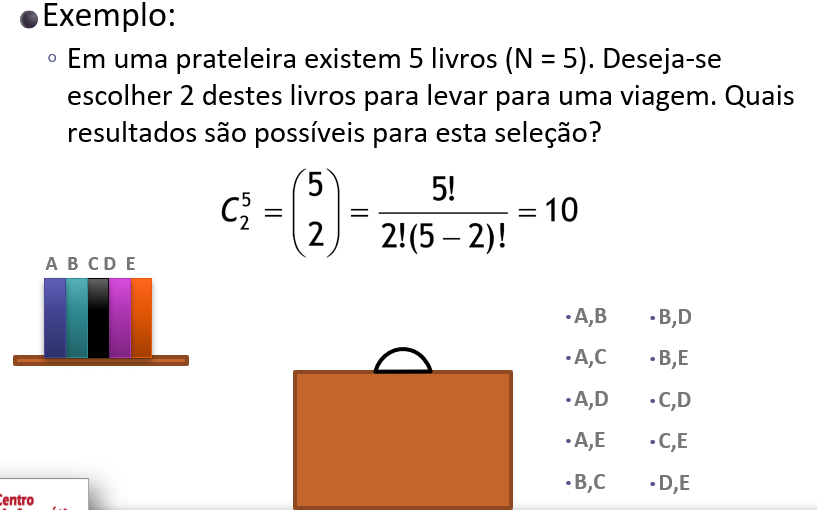
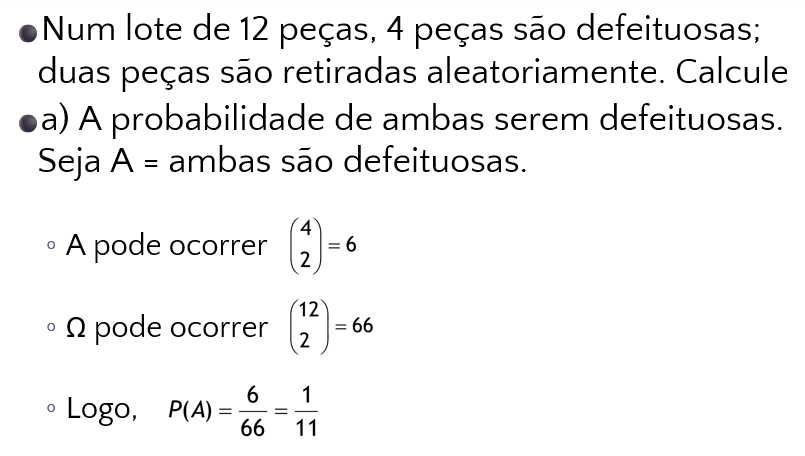
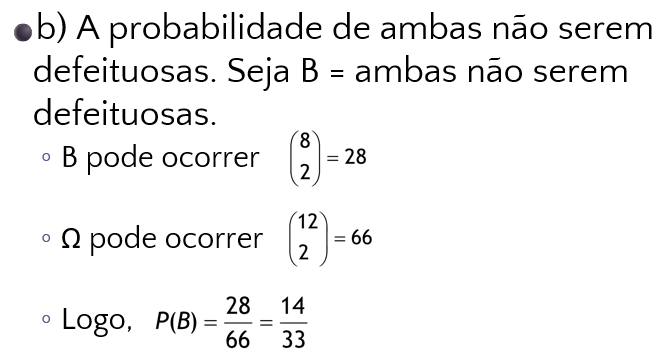
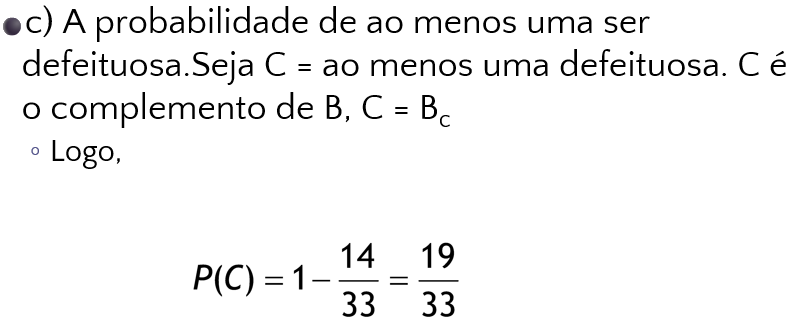
Permutação — arranjo de \(n\) elementos considerando a ordem: \(P_n = n!\) (ou \(\dfrac{n!}{(n-k)!}\) para arranjos de \(k\) elementos escolhidos entre \(n\)).
Imagem de referência
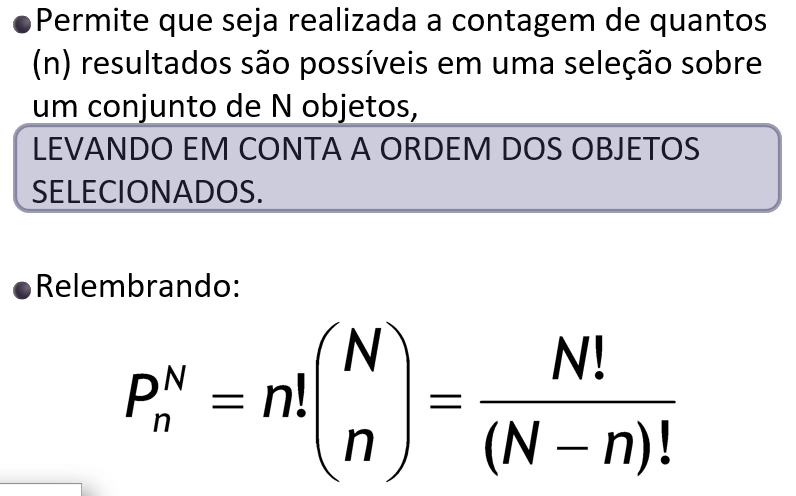
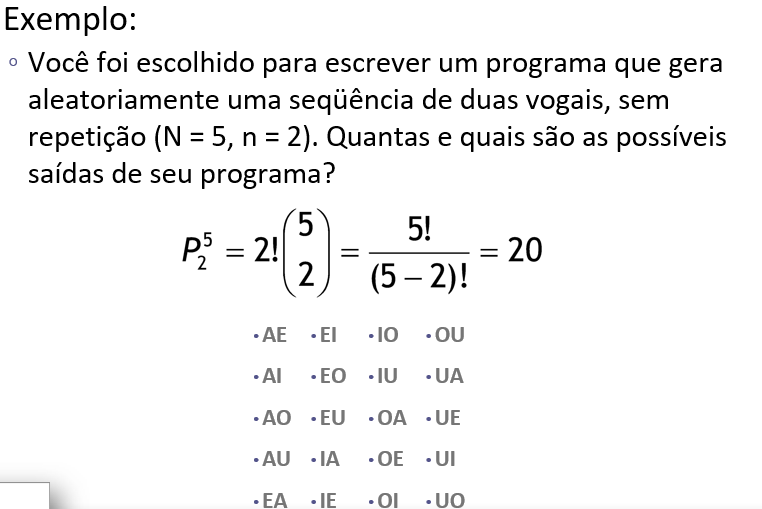
Example
Imagem de referência
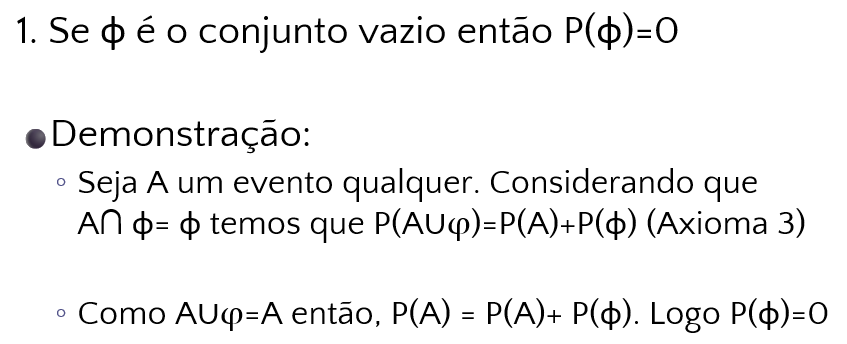
Teoremas de probabilidade
Teorema 1
Imagem de referência
Teorema 2
Imagens de referência
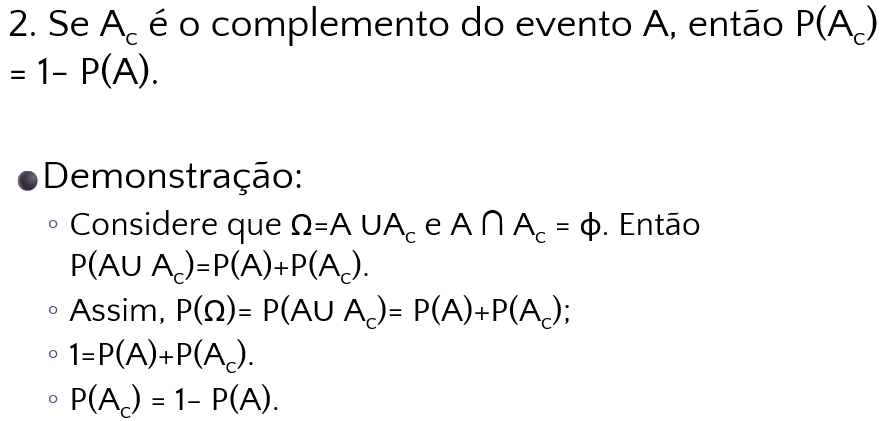
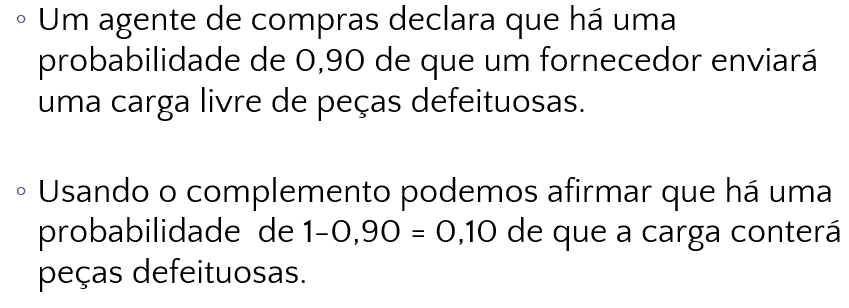
Teorema 3
Imagem de referência
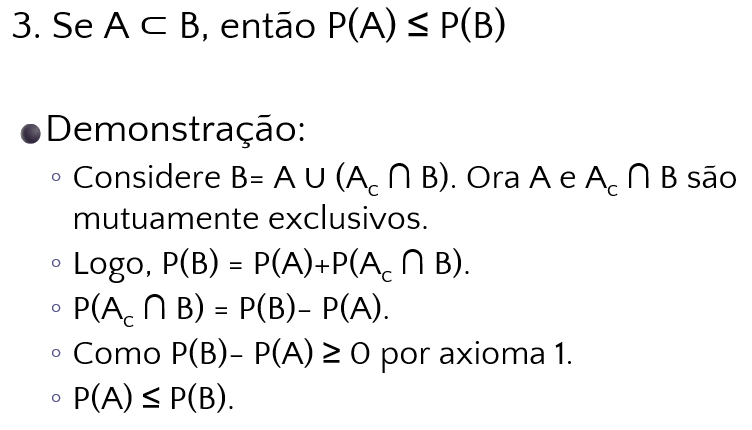
Teorema 4
Imagens de referência
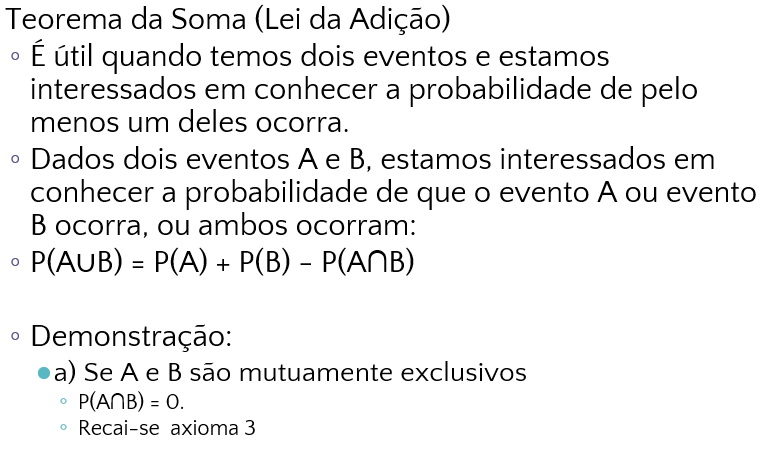
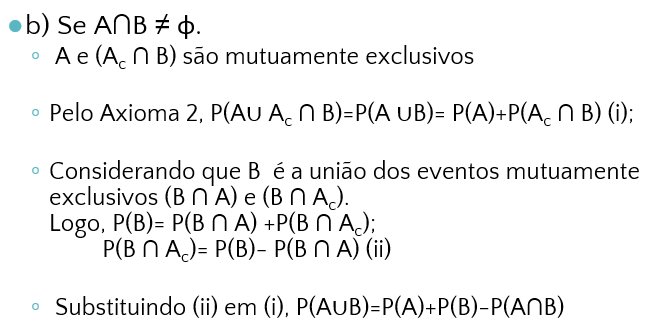
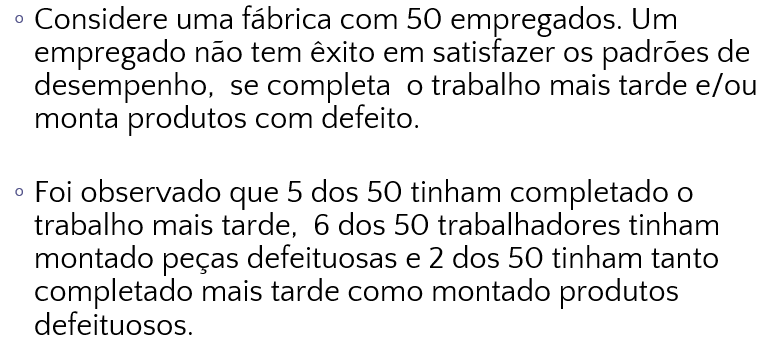
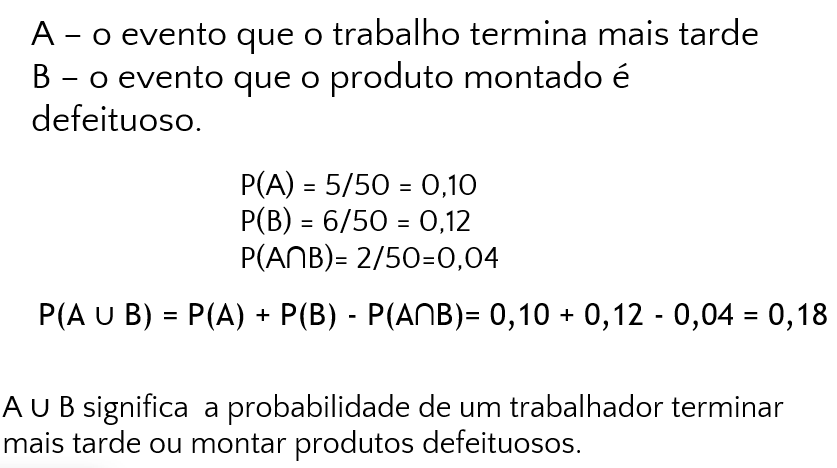
Probabilidades dos espaços amostrais
Imagem de referência
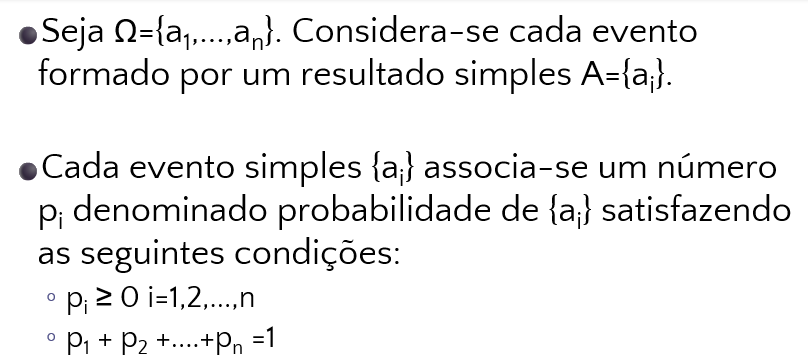
Example
Imagens de referência
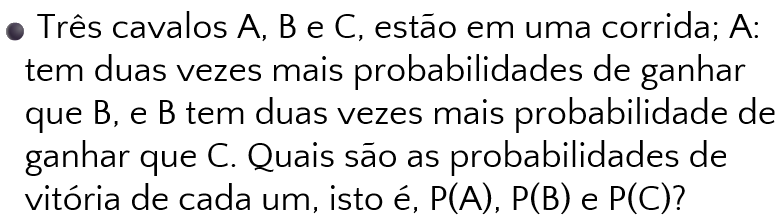
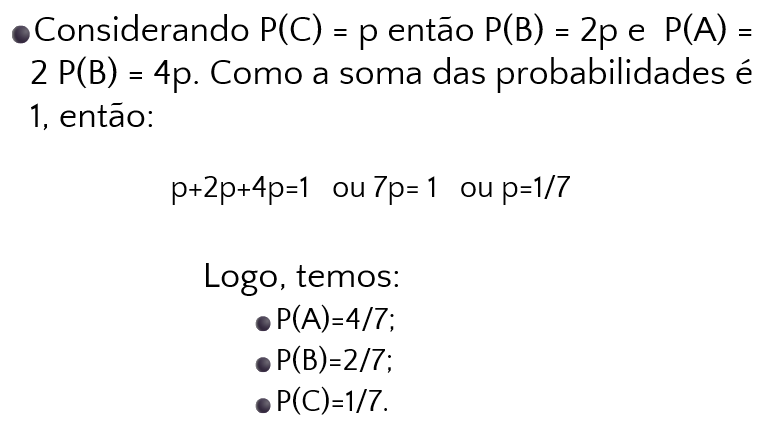
Exercício
Imagem de referência
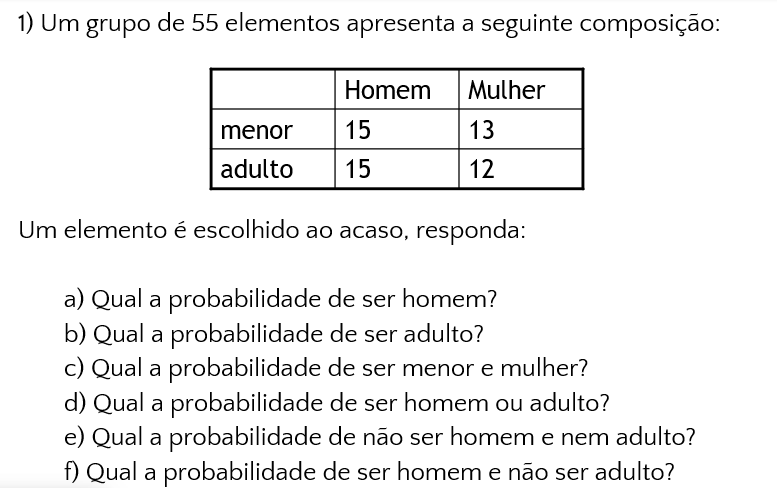
| Item | Probabilidade |
|---|---|
| a | \(30/55\) |
| b | \(27/55\) |
| c | \(13/55\) |
| d | \(42/55\) |
| e | \(13/55\) |
| f | \(15/55\) |
Probabilidade condicional
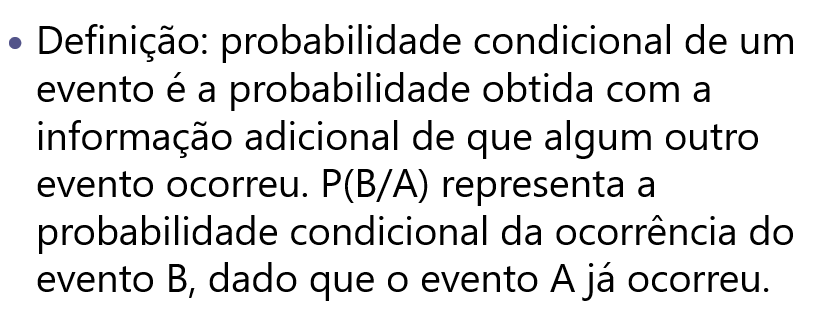
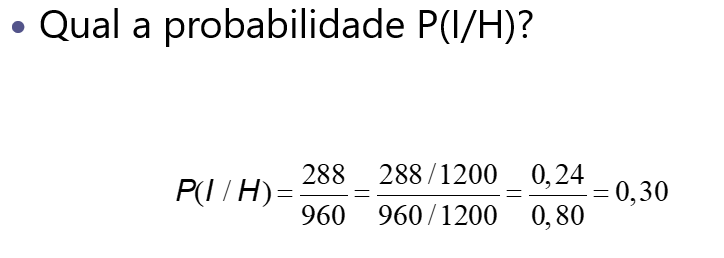
A probabilidade condicional \(P(A \mid B)\) mede a probabilidade de \(A\) ocorrer, dado que sabemos que \(B\) já ocorreu.
Imagens de referência
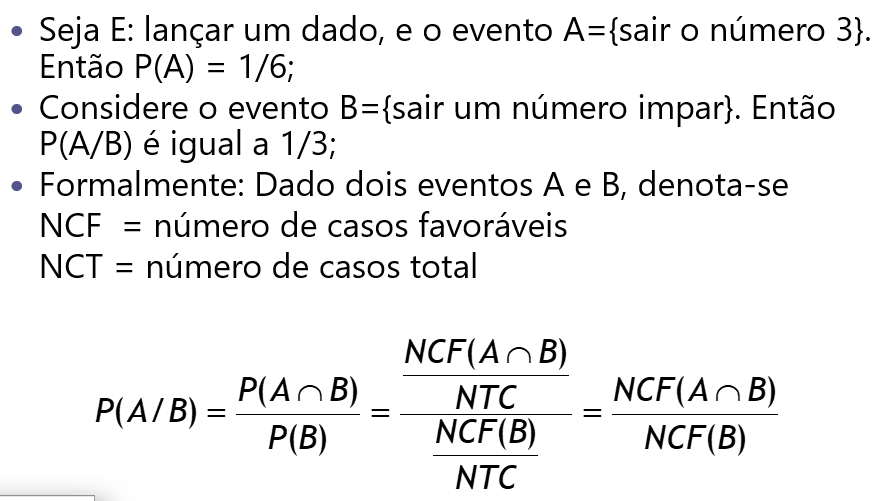
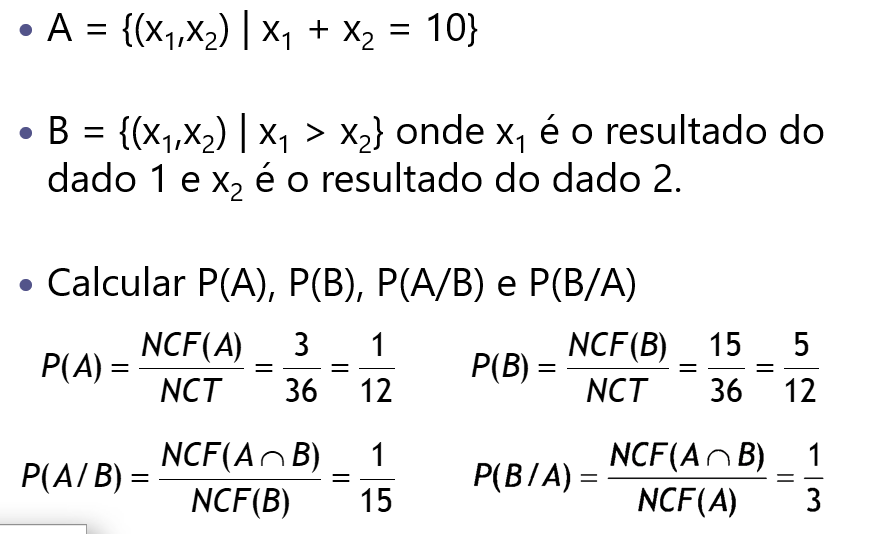
Exemplo 1 — lançamento de dois dados
Imagem de referência
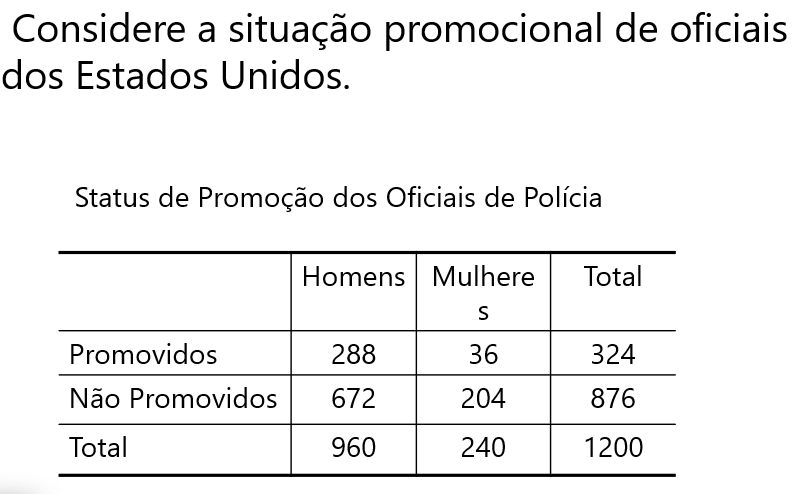
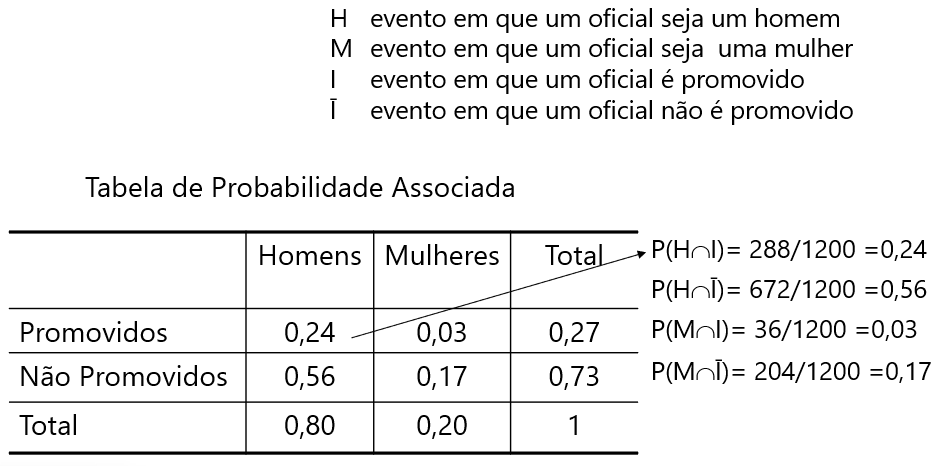
Exemplo 2
Imagens de referência
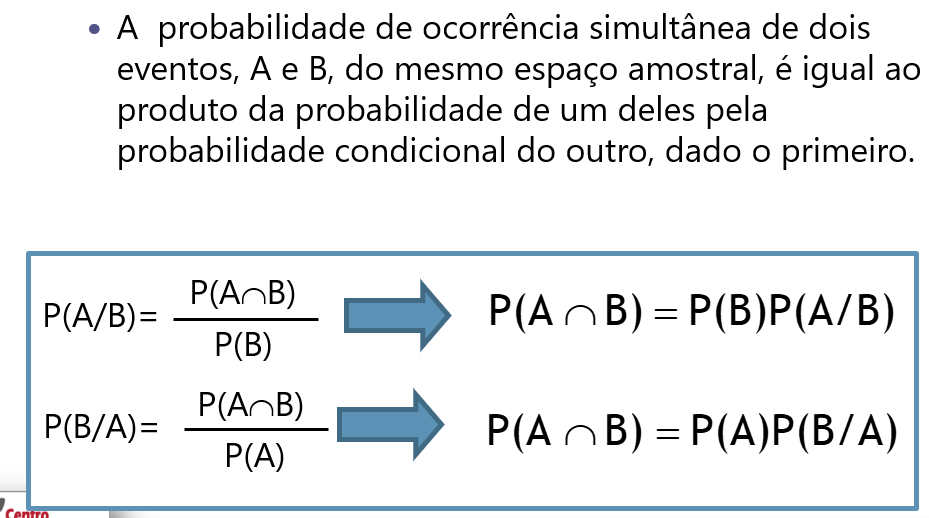
Teorema do produto
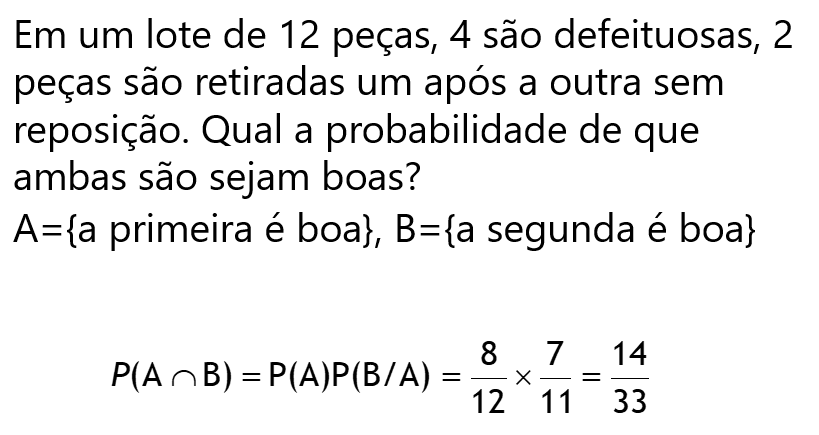
O teorema do produto permite calcular a probabilidade da interseção de dois eventos a partir da probabilidade condicional: \(P(A \cap B) = P(A \mid B) \cdot P(B)\).
Imagem de referência
Example
Imagem de referência
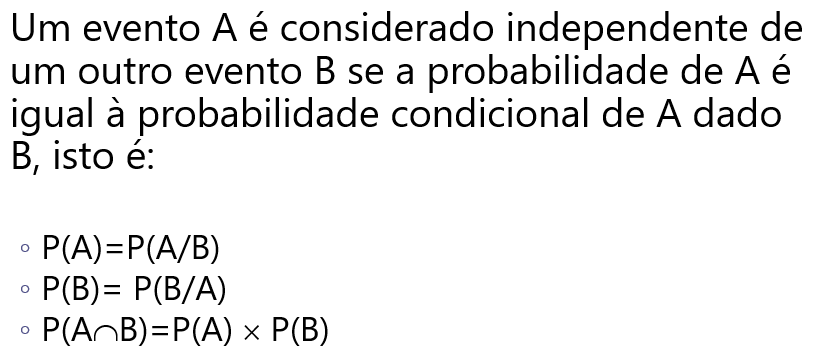
Independência estatística
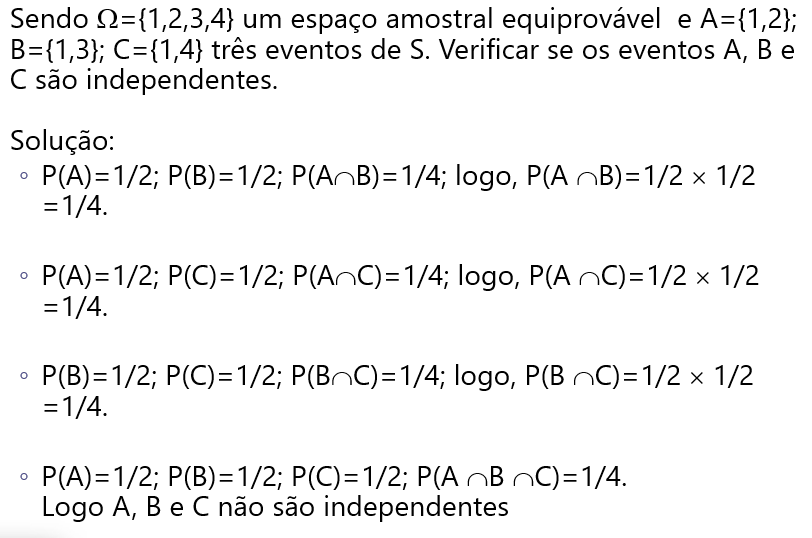
Dois eventos \(A\) e \(B\) são estatisticamente independentes quando a ocorrência de um não afeta a probabilidade do outro: \(P(A \mid B) = P(A)\), o que equivale a \(P(A \cap B) = P(A) \cdot P(B)\).
Imagem de referência
Example
Imagem de referência
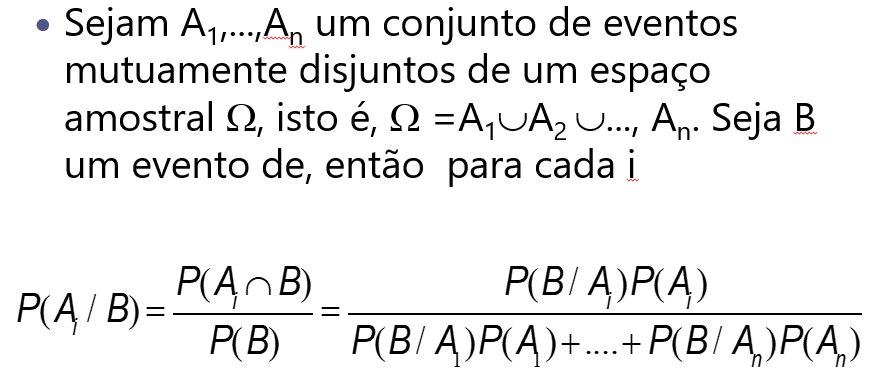
Teorema de Bayes
O Teorema de Bayes permite "inverter" uma probabilidade condicional, relacionando \(P(A \mid B)\) com \(P(B \mid A)\):
Imagem de referência
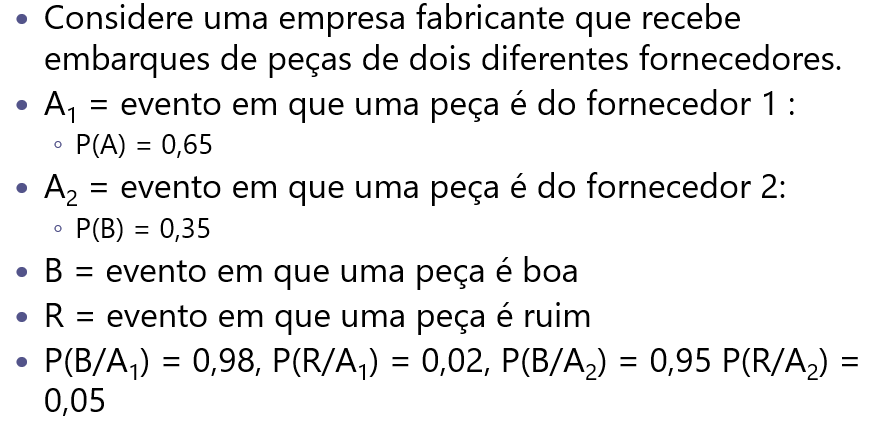
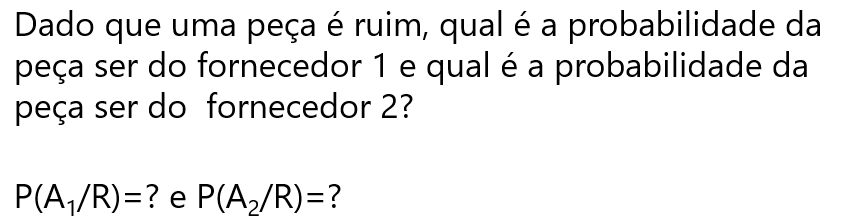
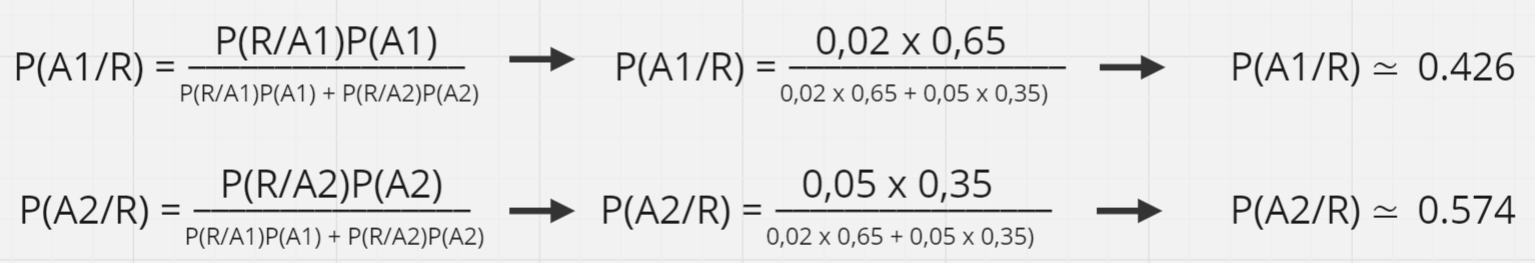
Example
Imagens de referência
Variáveis aleatórias
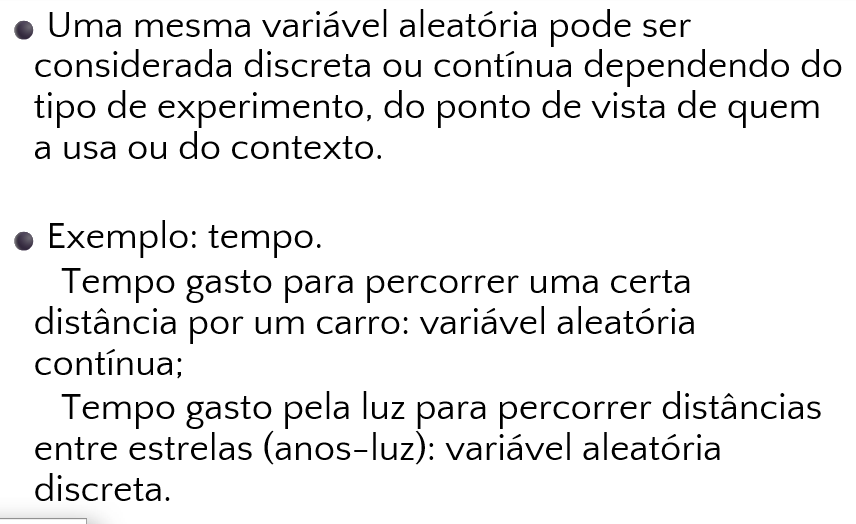
Uma variável aleatória é uma variável que assume um único valor numérico, determinado pelo acaso, para cada resultado de um experimento.
-
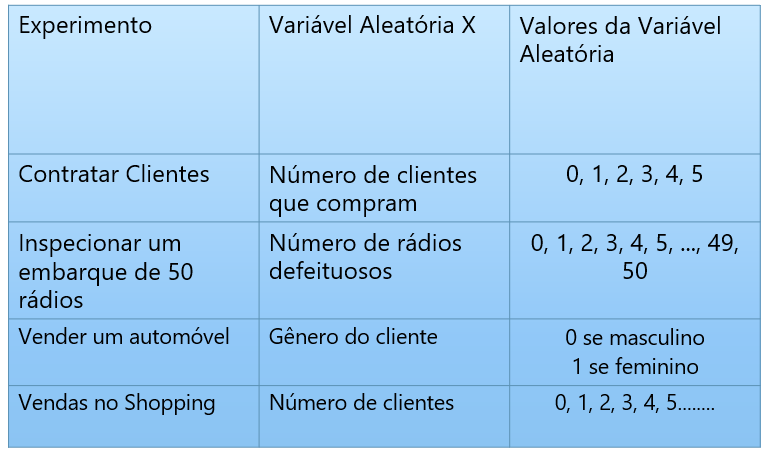
Discreta — tem um número finito de valores, ou uma quantidade enumerável de valores ("enumerável" significa que, mesmo havendo infinitos valores possíveis, eles podem ser associados a um processo de contagem, como os números naturais).
Example
Imagem de referência
-
Contínua — tem infinitos valores possíveis, associados a medidas em uma escala contínua, sem "pulos" ou interrupções.
Example
Imagem de referência
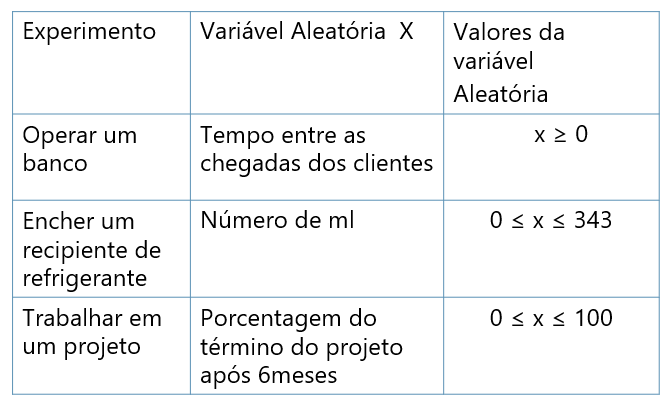
Imagem de referência
Função de probabilidade (distribuição de probabilidade)
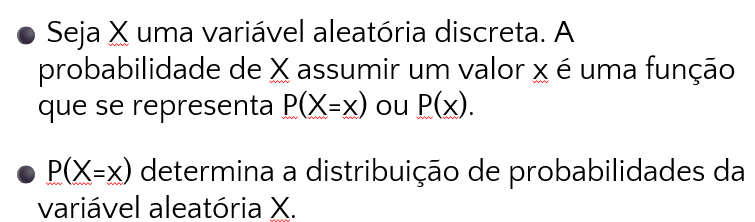
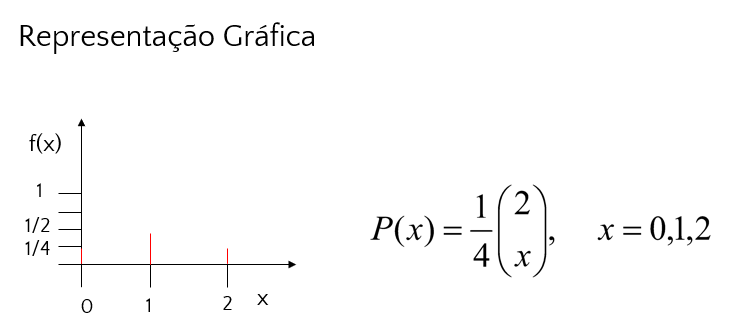
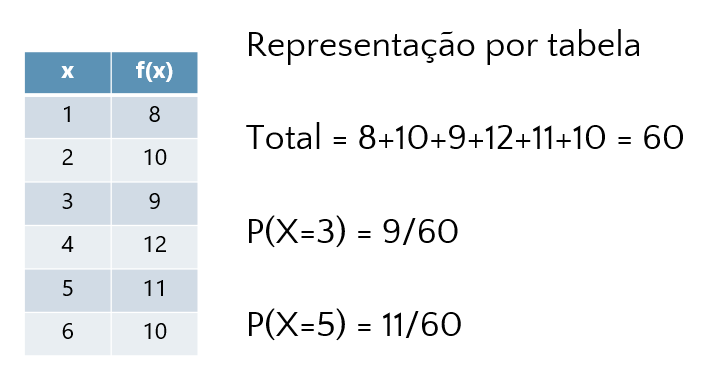
É um gráfico, tabela ou fórmula que dá a probabilidade de cada valor possível da variável aleatória — a associação entre a variável aleatória e sua probabilidade.
Imagem de referência
Representações
-
Gráfica:
Imagem de referência
-
Tabela:
Imagem de referência
Função de uma variável aleatória
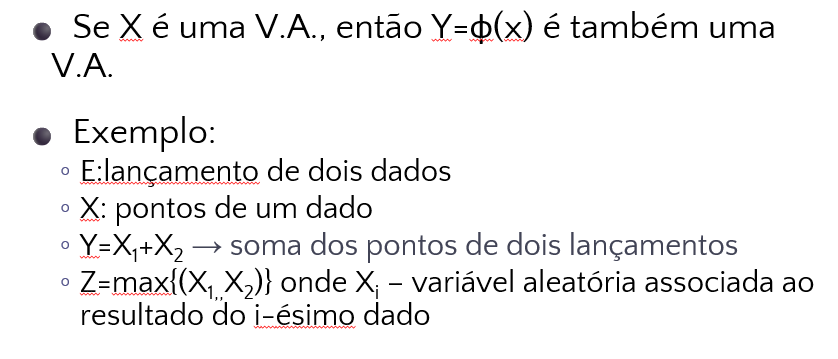
Qualquer função de uma variável aleatória também é, ela mesma, uma variável aleatória.
Imagem de referência
Example
Imagens de referência
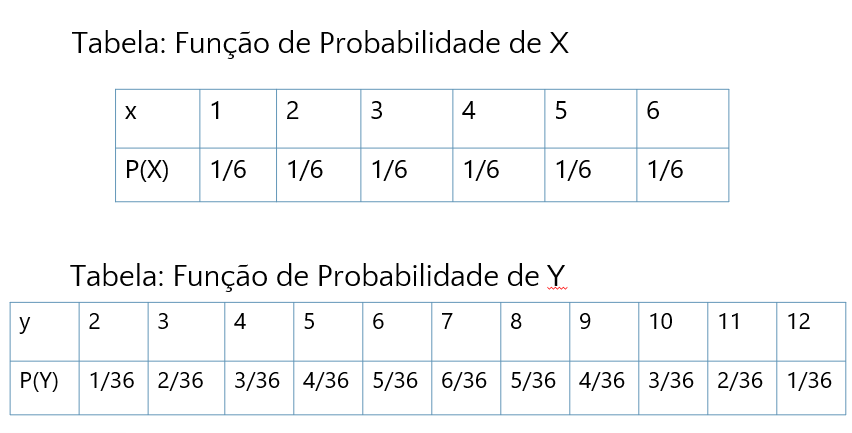
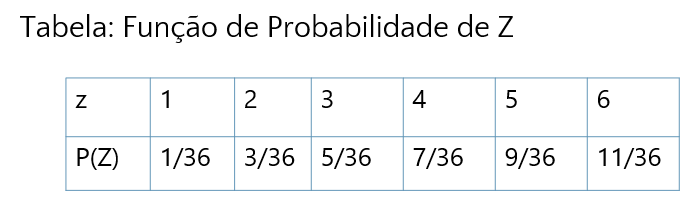
Função de distribuição (de repartição)
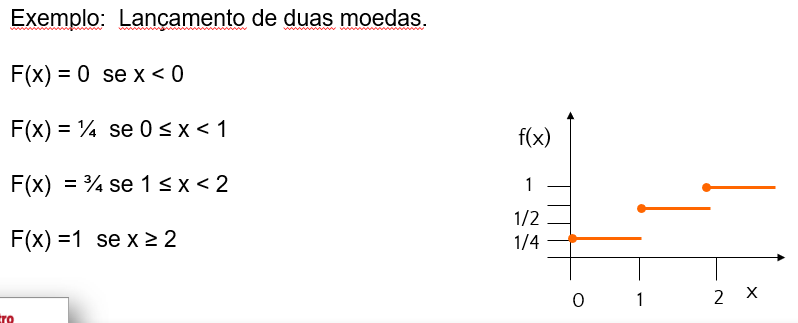
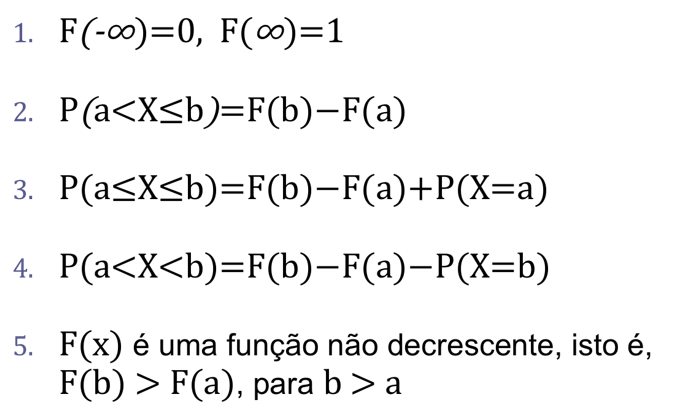
Seja \(X\) uma variável aleatória discreta. A função de distribuição \(F(x)\) é definida como a probabilidade de que \(X\) assuma um valor menor ou igual a \(x\): \(F(x) = P(X \leq x)\).
Imagem de referência
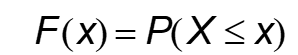
Example
Imagem de referência
Propriedades
Imagem de referência
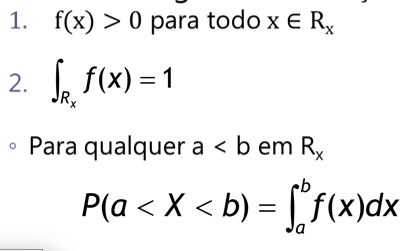
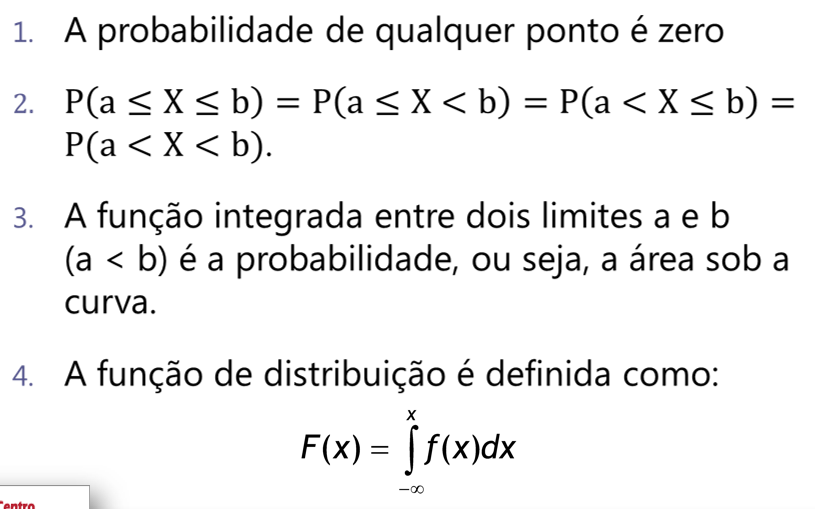
Função de densidade de probabilidade (fdp)
Seja \(X\) uma variável aleatória contínua. A função de densidade de probabilidade \(f(x)\) satisfaz as seguintes condições (não-negatividade e integral total igual a 1):
Imagem de referência
Note
Imagem de referência
Exemplos
-
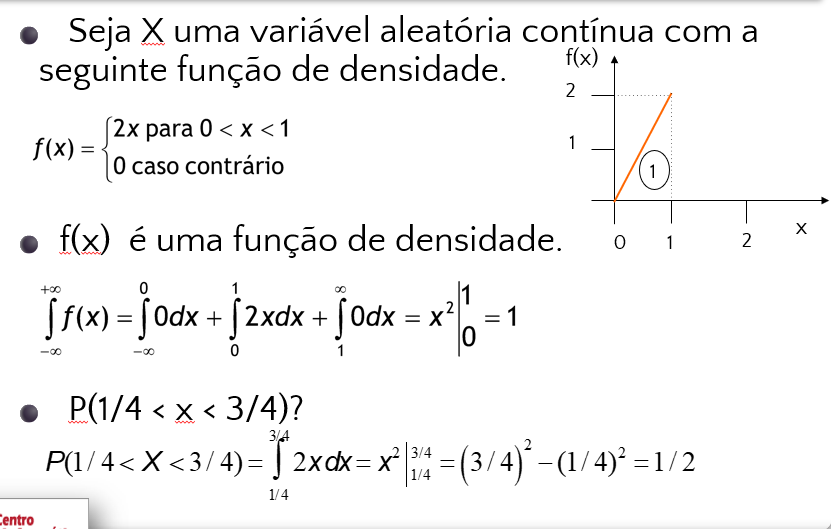
Imagem de referência
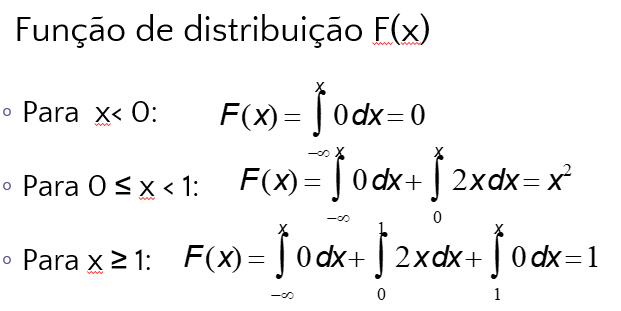
-
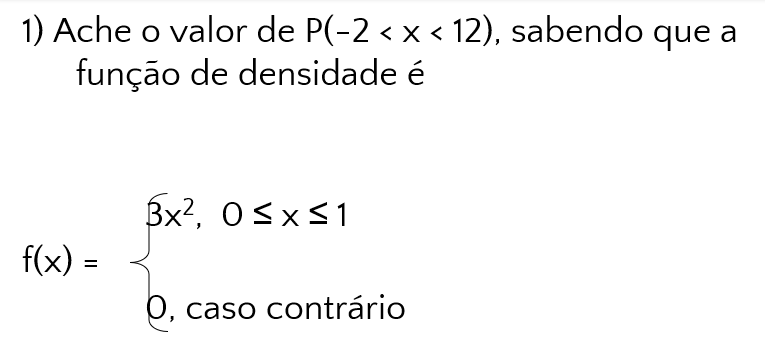
Imagem de referência
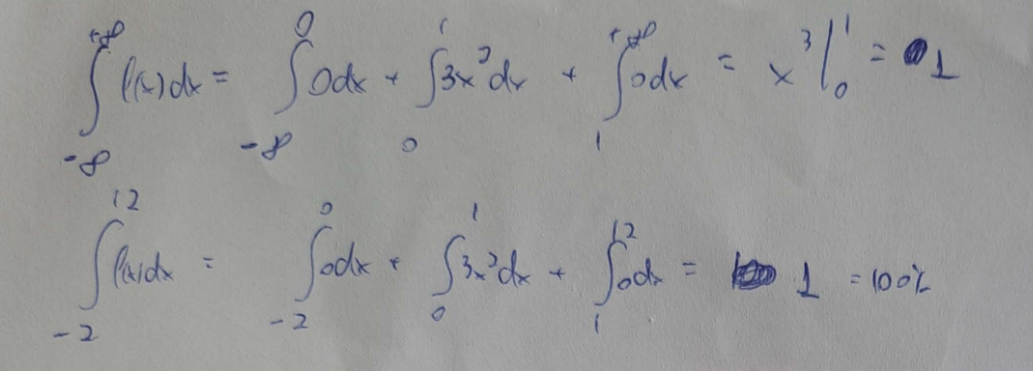
-
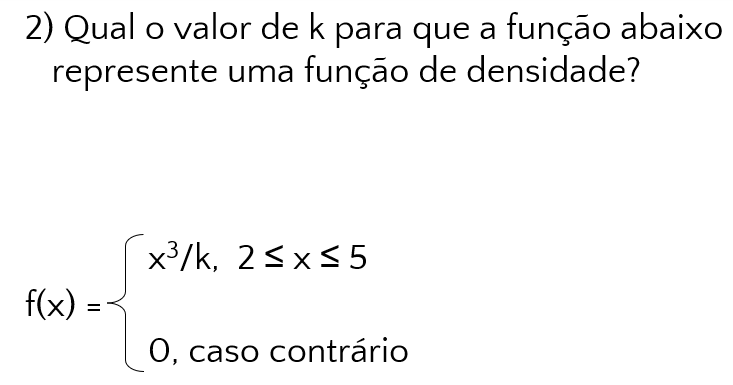
Imagem de referência
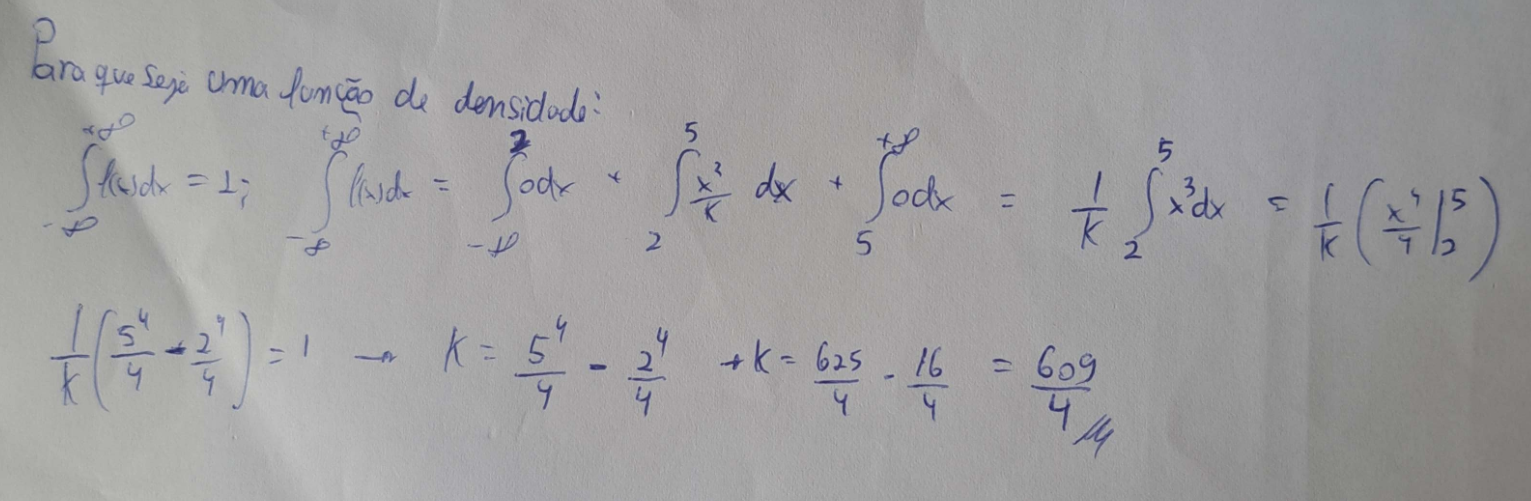
-
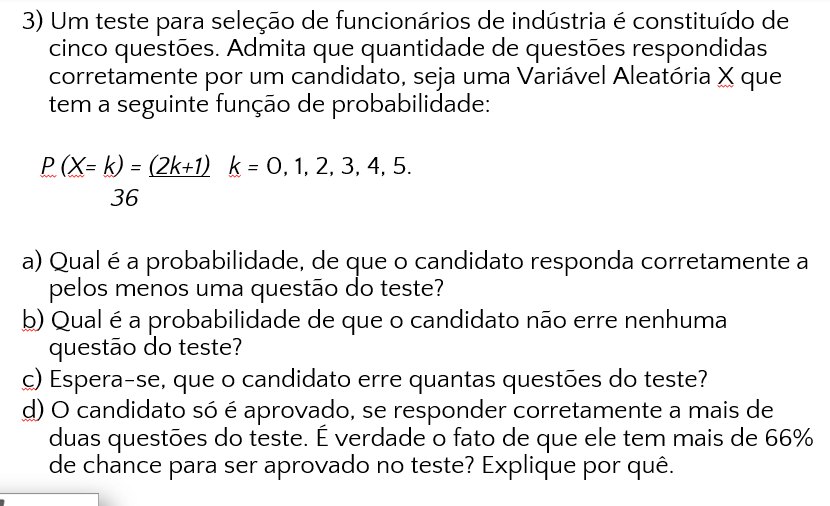
Imagem de referência
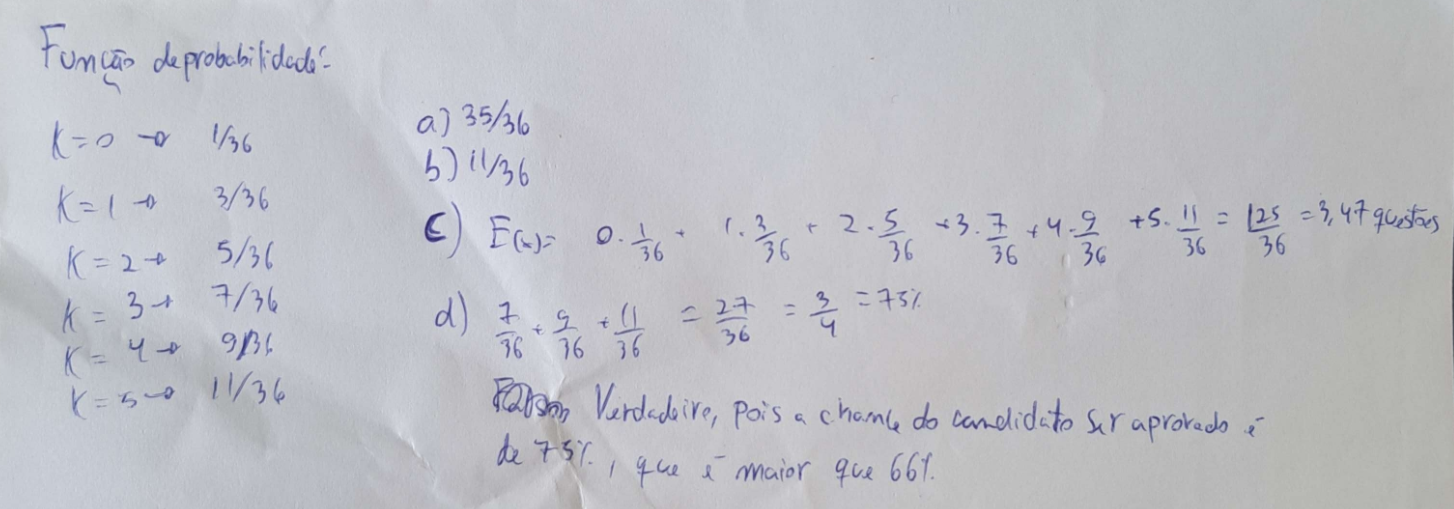
(Utiliza o conceito de esperança matemática, abordado a seguir.)
Medidas de variáveis aleatórias
Medidas de posição
Esperança matemática (valor esperado ou média)
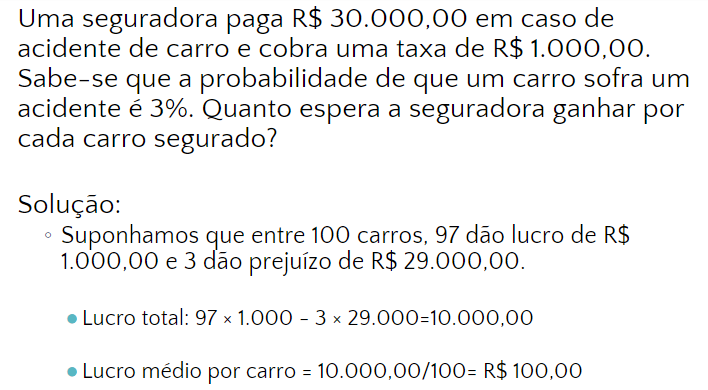
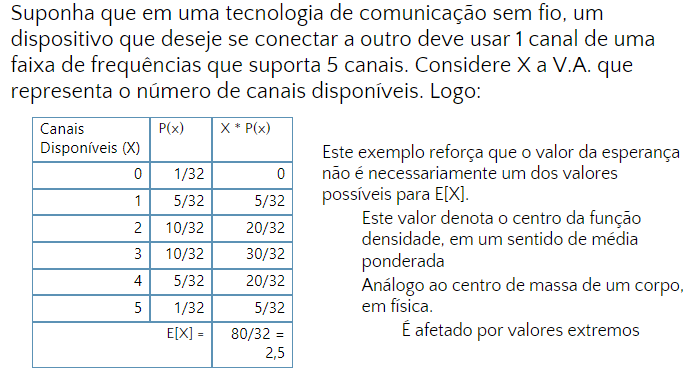
O valor esperado de uma variável aleatória é a soma do produto de cada valor possível pela sua respectiva probabilidade — é um número real, e também pode ser visto como uma média ponderada. Notação: \(\mu\) ou \(\mu_X\).
Example
Imagens de referência
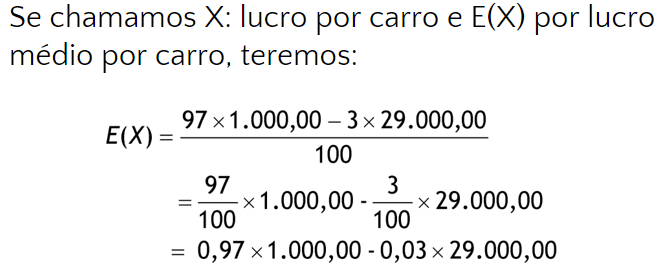
Esperança de uma variável discreta
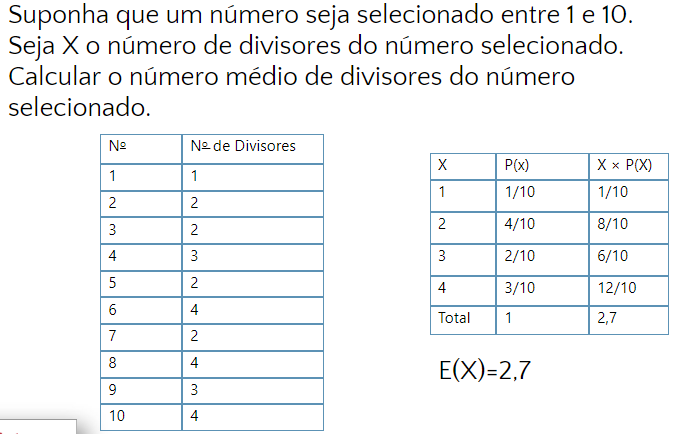
Seja \(X\) uma variável aleatória discreta com valores possíveis \(x_1, x_2, \ldots, x_n\), e seja \(p(x_i) = P(X = x_i)\), \(i = 1, \ldots, n\). O valor esperado de \(X\) é:
Imagem de referência
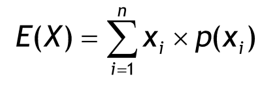
Example
Imagem de referência
Esperança de uma variável contínua
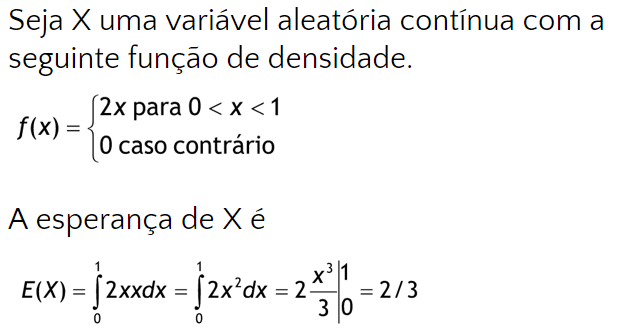
Seja \(X\) uma variável aleatória contínua com função de densidade \(f(x)\). O valor esperado de \(X\) é:
Imagem de referência
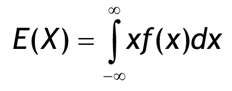
Example
Imagem de referência
Example
Imagem de referência
Propriedades
Imagem de referência
Interpretação prática
Do ponto de vista estatístico, a média pode indicar a "honestidade" de um determinado evento: quando a média tende a um valor menor que o esperado por acaso, isso pode sugerir que o evento não é justo (por exemplo, um jogo manipulado).
Mediana
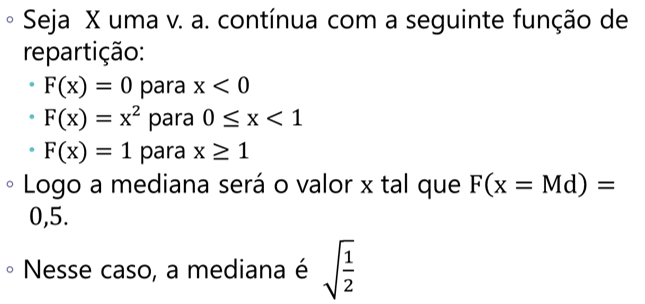
A mediana de uma variável aleatória é o valor que divide a distribuição em duas partes iguais, ou seja, \(F(M_d) = 0{,}5\), onde \(M_d\) é a mediana e \(F(X)\) é a função de distribuição.
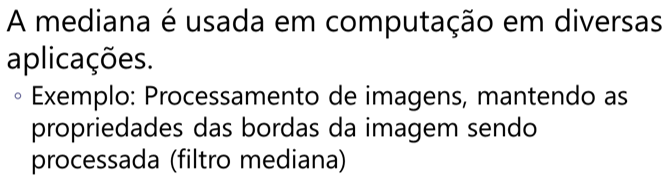
Aplicações
Imagem de referência
Example
Imagem de referência
Moda
- Definição discreta — o valor de \(X\) com maior probabilidade.
- Definição contínua — o valor de \(X\) com maior densidade.
Example
Discreta:
Imagem de referência
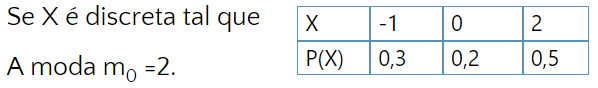
Contínua:
Imagem de referência
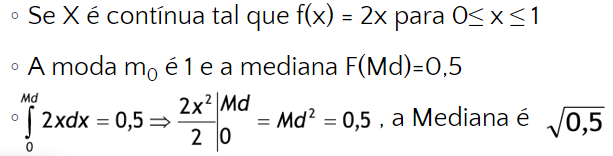
Medidas de dispersão
Variância
A variância de uma variável aleatória mede o quanto seus valores se afastam, em média, da esperança:
Imagem de referência
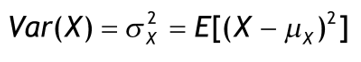
-
Para \(X\) discreta:
Imagem de referência
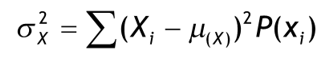
A variância de \(X\) é o somatório de \((x_i - E(X))^2\) ponderado pela probabilidade \(p(x_i)\).
-
Para \(X\) contínua:
Imagem de referência
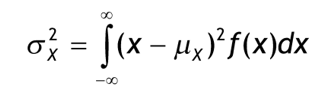
A variância de \(X\) é a integral, de \(-\infty\) a \(+\infty\), de \((x - E(X))^2 \cdot f(x)\).
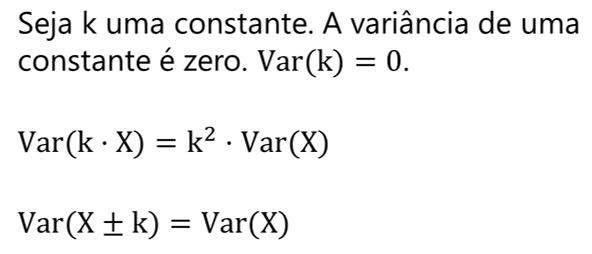
Propriedades
Imagem de referência
Desvio padrão
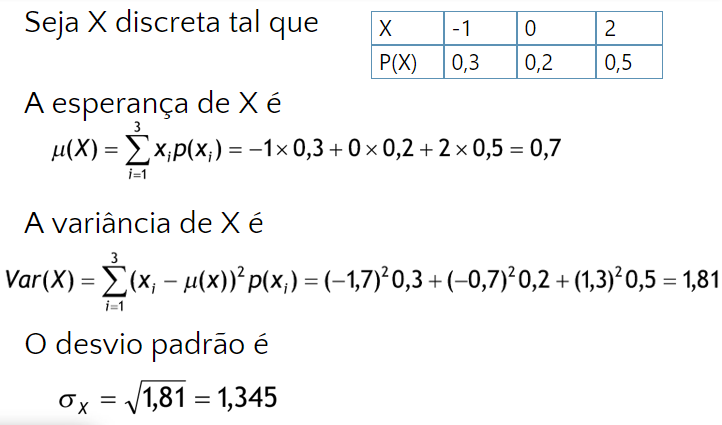
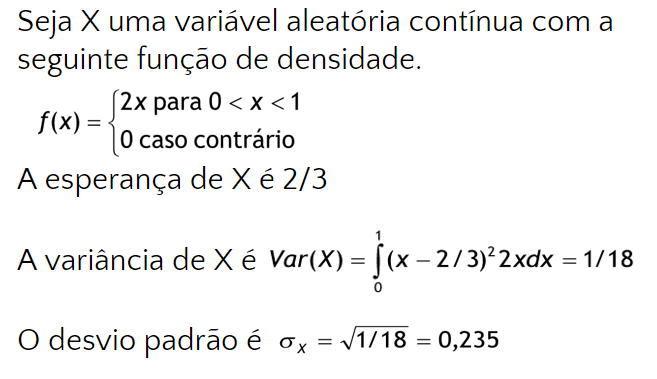
O desvio padrão é a raiz quadrada da variância: \(\sigma = \sqrt{\text{Var}(X)}\).
Imagem de referência
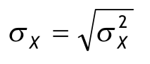
Exemplos
-
-
-
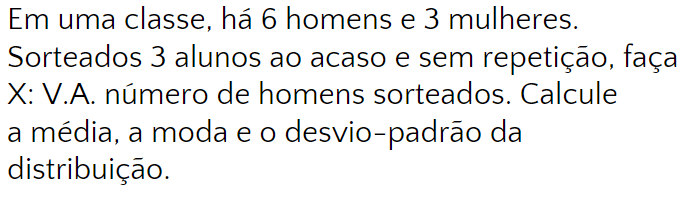
Imagem de referência
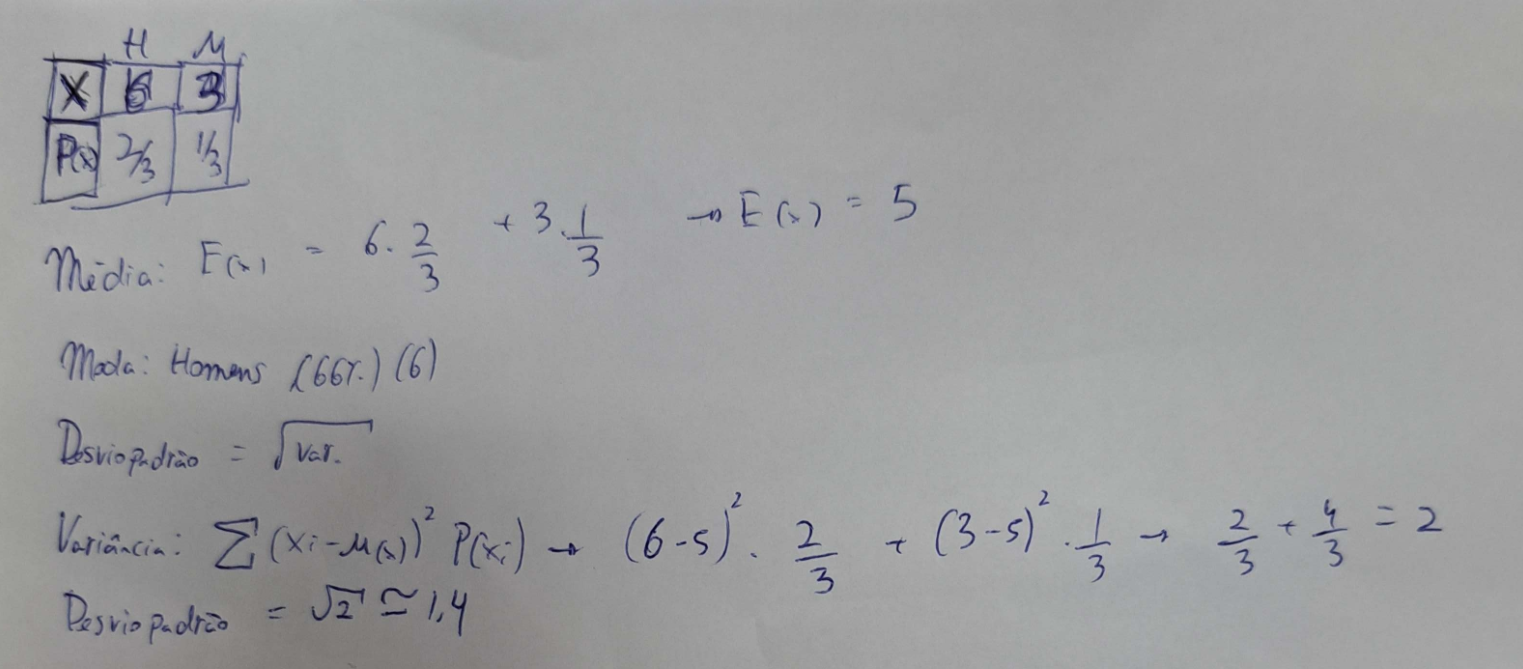
-
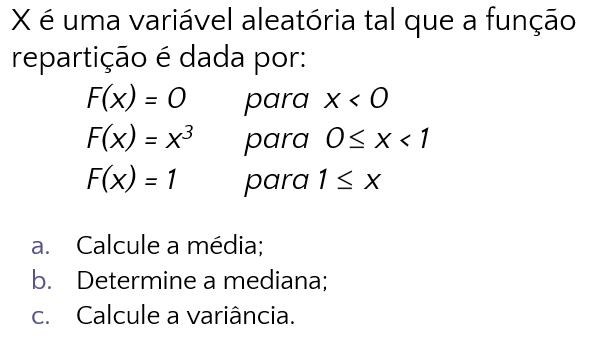
(Exemplo ainda não totalmente compreendido — revisar com o material da disciplina.)
-
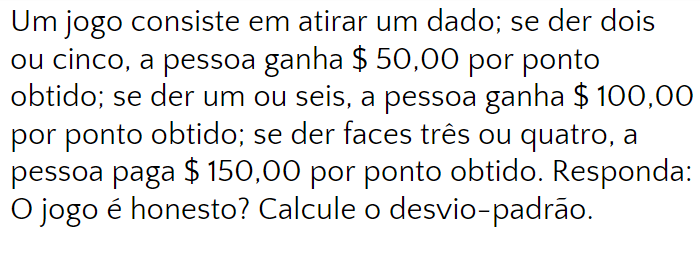
Imagem de referência
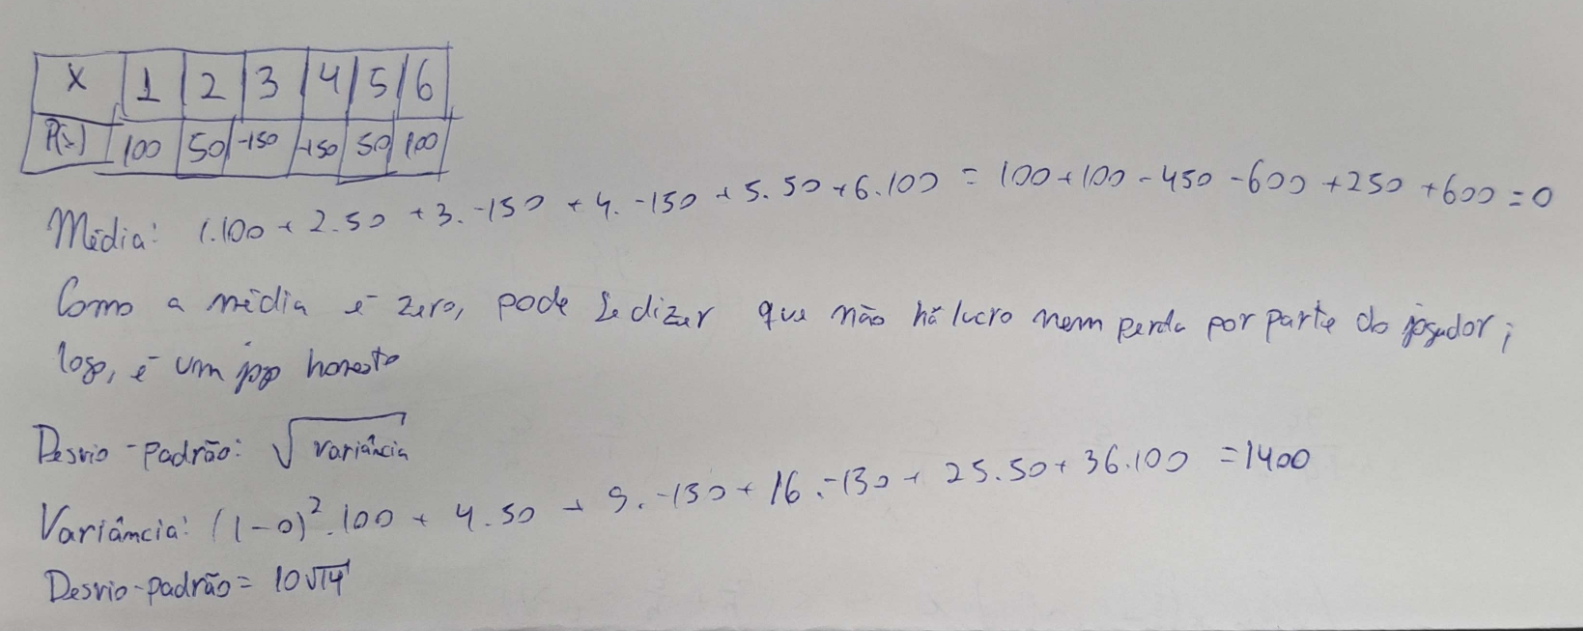
(Resolução possivelmente contém erro — revisar.)
Distribuições de probabilidade
Modelos de distribuição discretas
As distribuições discretas mais comuns compartilham a ideia de "ensaios" (tentativas) com dois ou mais resultados possíveis. A tabela a seguir resume as principais:
| Distribuição | Cenário típico | \(E(X)\) | \(\text{Var}(X)\) |
|---|---|---|---|
| Bernoulli | Um único ensaio, sucesso/fracasso | \(p\) | \(pq\) |
| Binomial | \(n\) ensaios independentes, com reposição | \(np\) | \(npq\) |
| Geométrica | Ensaios até o primeiro sucesso | \(1/p\) | \(q/p^2\) |
| Poisson | Ocorrências em um intervalo de tempo/espaço | \(\lambda\) | \(\lambda\) |
| Hipergeométrica | Amostragem sem reposição | — | — |
Distribuição de Bernoulli
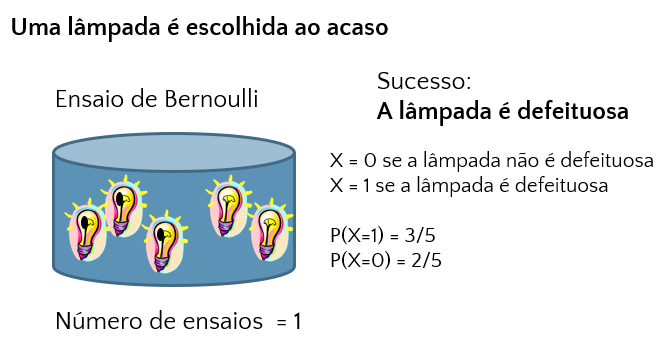
Seja \(X\) uma variável aleatória com dois resultados possíveis: fracasso ou sucesso. A probabilidade de sucesso é \(P(X=1) = p\), e a de fracasso é \(P(X=0) = 1-p = q\).
- Valor esperado: \(E(X) = \mu_X = p\).
- Variância: \(\text{Var}(X) = \sigma^2 = pq\).
Example
Imagem de referência
Distribuição binomial
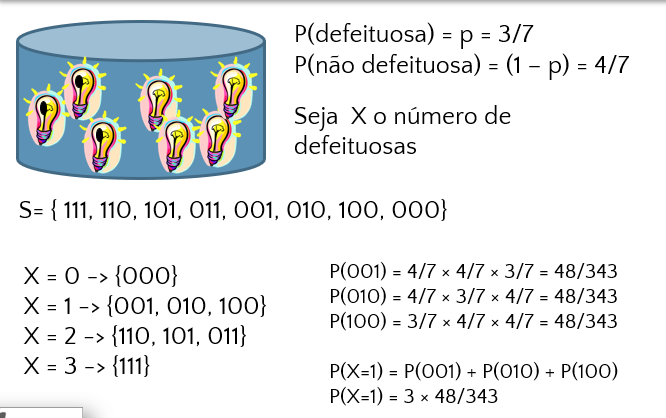
Modela sucessos ou fracassos sucessivos e independentes (como ensaios com reposição), em que a probabilidade \(p\) (e \(1-p\)) é a mesma em cada ensaio.
Example
Imagem de referência
Função de probabilidade
Imagens de referência
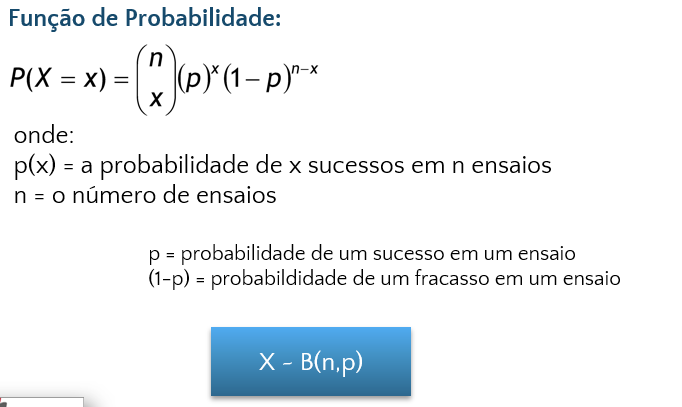
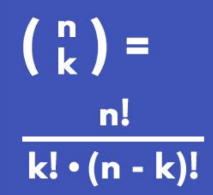
Seja \(X\) uma variável aleatória binomial com parâmetros \(n\) (número de ensaios) e \(p\) (probabilidade de sucesso): \(X \in \{0, 1, 2, \ldots, n\}\).
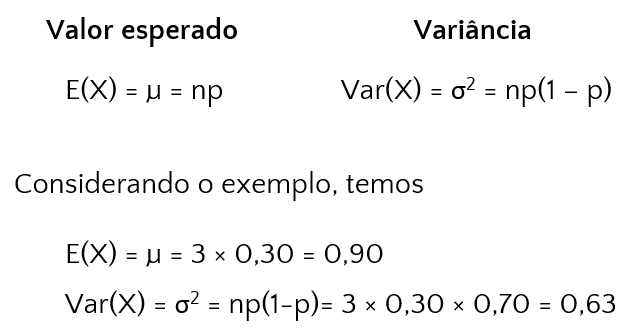
- Valor esperado: \(E(X) = \mu_X = np\).
- Variância: \(\text{Var}(X) = \sigma^2 = npq\).
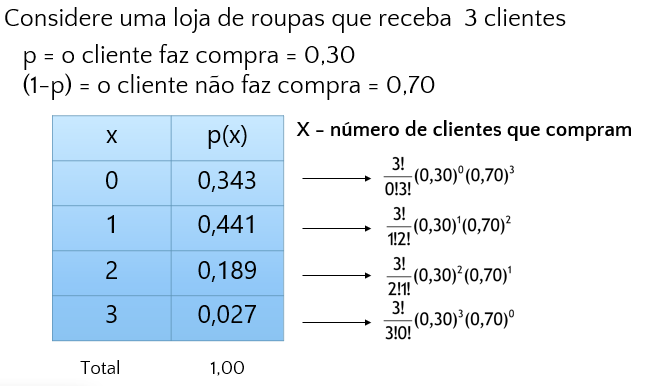
Example
Imagens de referência
Distribuição geométrica
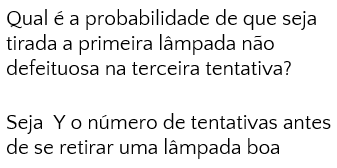
Modela o número de tentativas sucessivas até o primeiro sucesso, com dois resultados possíveis por tentativa, probabilidades constantes (\(p\) e \(1-p\)) e ensaios independentes (com reposição).
Example
Imagens de referência
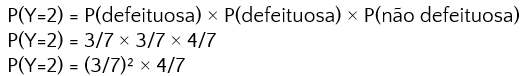
Função de probabilidade
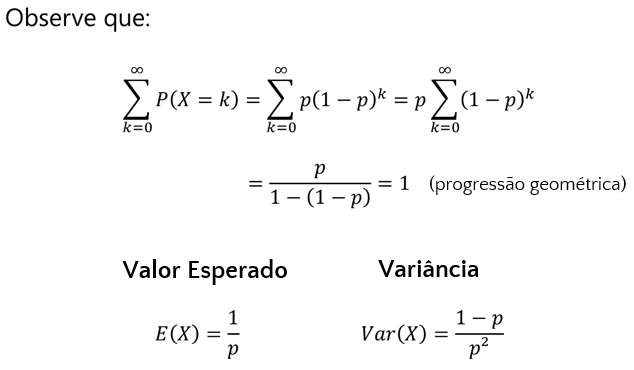
Considerando uma sequência de ensaios de Bernoulli, a distribuição geométrica dá a probabilidade de que sejam necessários \(k\) ensaios até o primeiro sucesso:
Imagem de referência
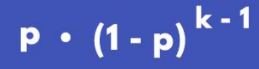
onde \(p\) é a probabilidade de sucesso, \((1-p)\) a de fracasso e \(k\) o número de ensaios.
Imagem de referência
Example
Imagem de referência
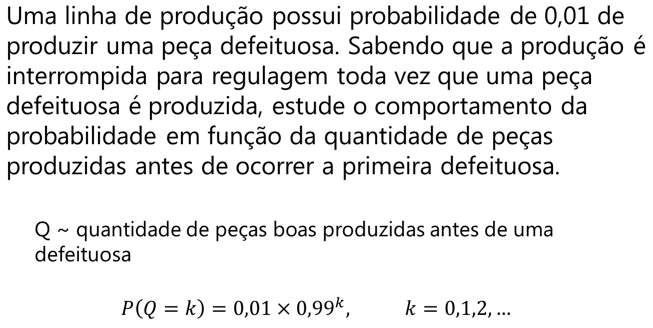
(O expoente correto no denominador/contagem de ensaios é \(k - 1\), não \(k\).)
Distribuição de Poisson
Modela o número de ocorrências de um evento em um intervalo específico de tempo ou espaço.
Exemplos de aplicação
Erros tipográficos por página; defeitos por unidade de área/comprimento em uma peça fabricada; mortes por ataque cardíaco por ano.
Propriedades
- A probabilidade de uma ocorrência é a mesma para quaisquer dois intervalos de igual tamanho.
- A ocorrência (ou não) em um intervalo é independente da ocorrência em qualquer outro intervalo.
Função de probabilidade
Imagem de referência
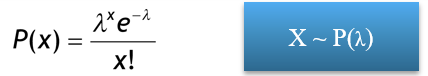
Onde:
- \(X\) é o número de ocorrências (sucessos).
- \(P(X)\) é a probabilidade de \(X\) ocorrências em um intervalo.
- \(\lambda\) é o valor esperado (número médio de ocorrências no intervalo).
- \(e\) é o número de Euler (\(\approx 2{,}71828\)).
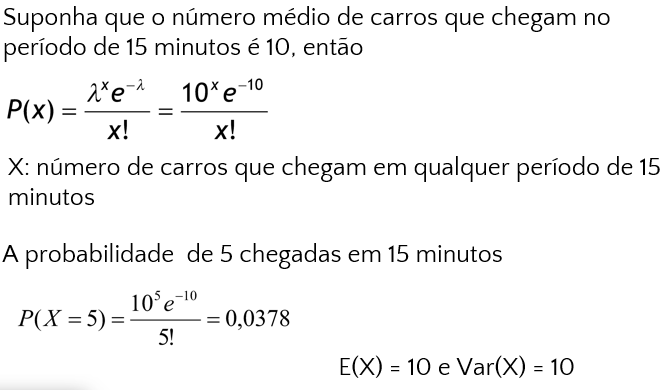
- Valor esperado: \(E(X) = \lambda\).
- Variância: \(\text{Var}(X) = \lambda\).
Exemplo 1
Imagem de referência
Exemplo 2
Numa fita de som, há um defeito a cada 200 pés. Qual é a probabilidade de que:
a) em 500 pés não aconteça nenhum defeito?
Imagem de referência
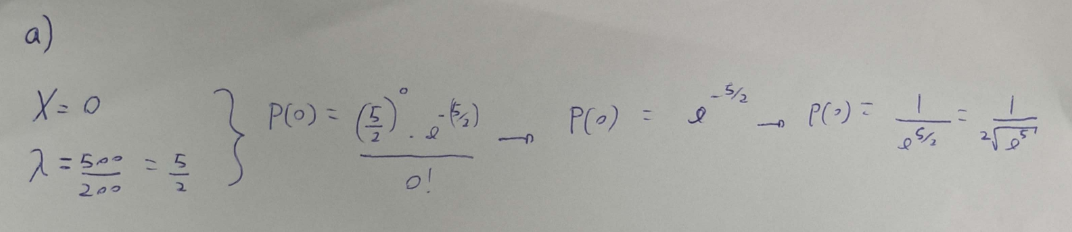
b) em 800 pés ocorram pelo menos 3 defeitos?
Imagem de referência
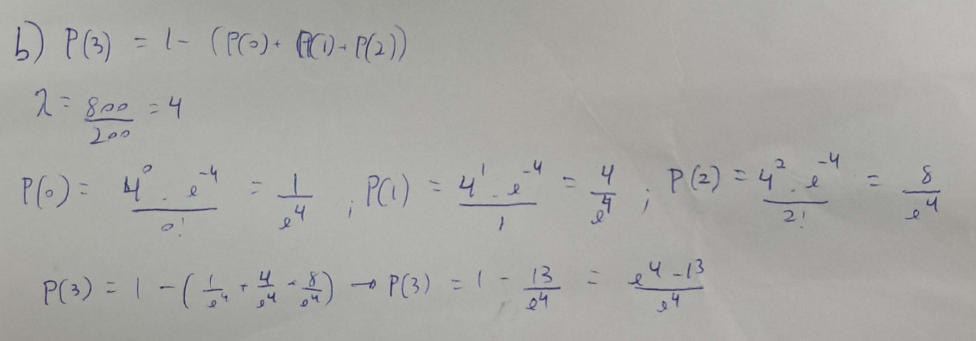
Distribuição hipergeométrica
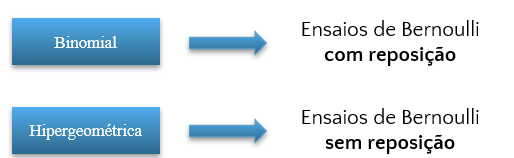
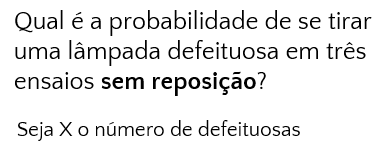
Semelhante à binomial, mas composta por \(r\) ensaios sem reposição — ou seja, os ensaios passam a ser dependentes. O conjunto é composto por dois tipos de objetos (dois resultados possíveis).
Imagem de referência
Example
Imagens de referência
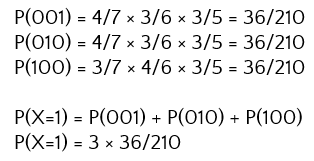
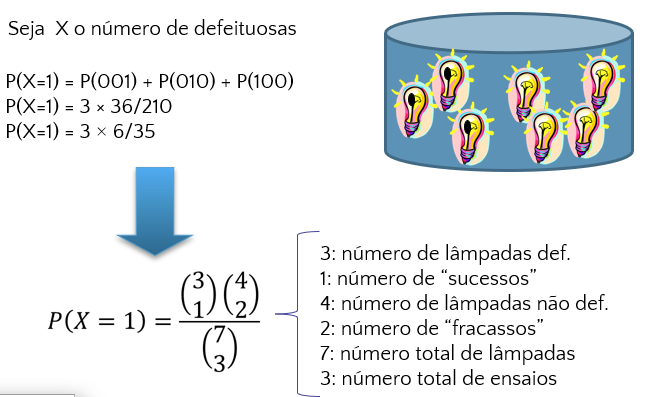
Função de probabilidade
Imagens de referência
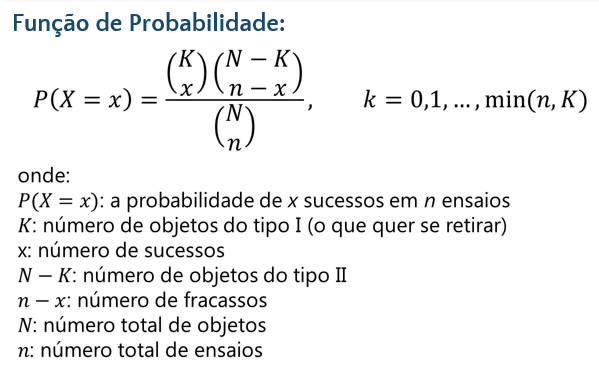
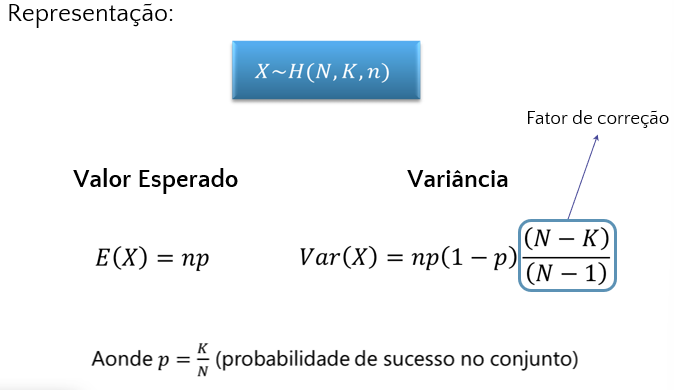
Exemplos (distribuições discretas)
-
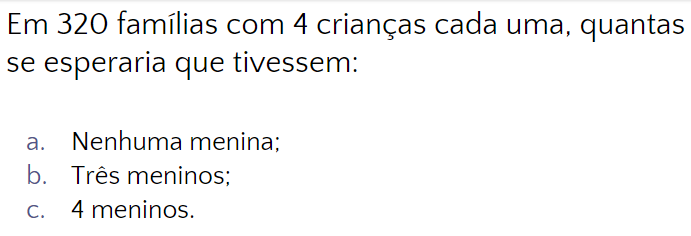
Imagem de referência
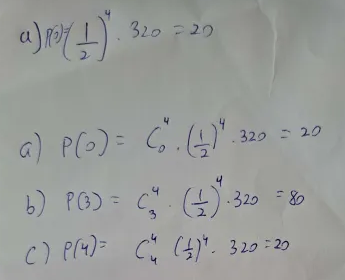
-
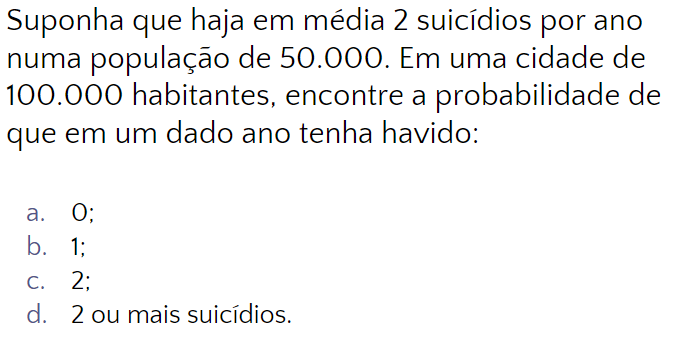
Imagem de referência
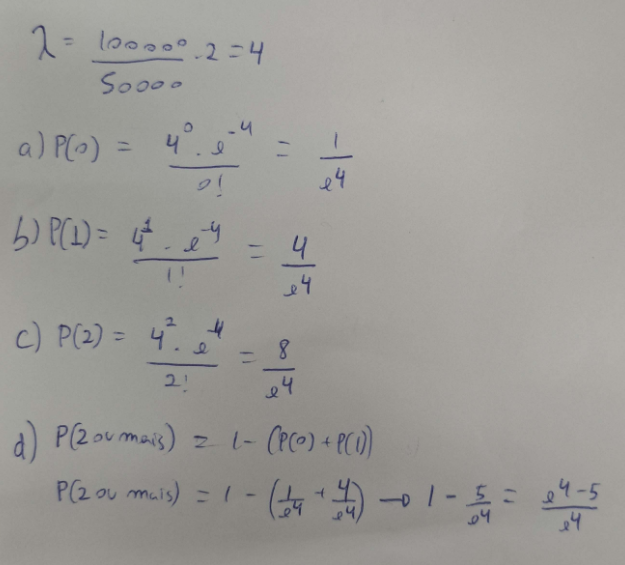
-
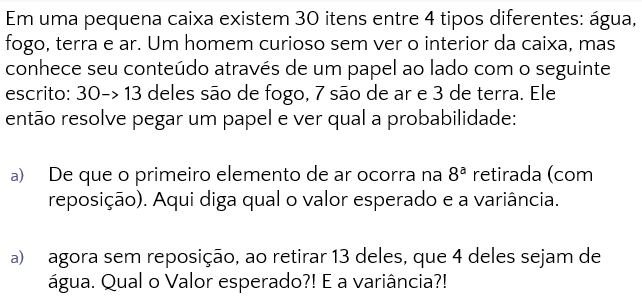
Imagem de referência
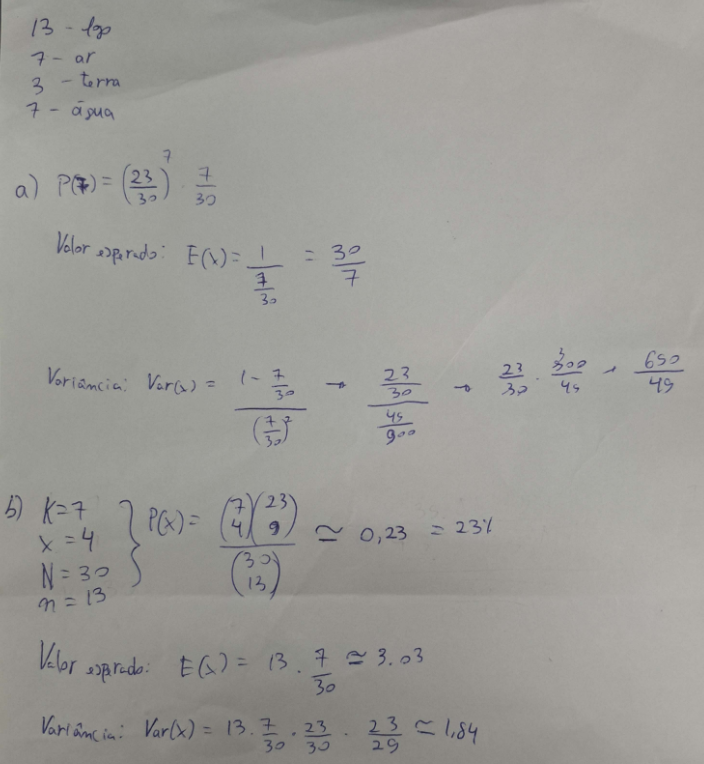
Modelos de distribuição contínuas
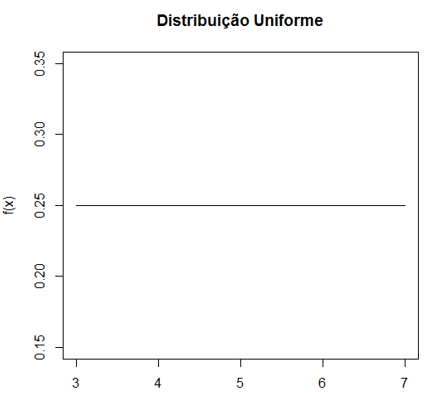
Distribuição uniforme
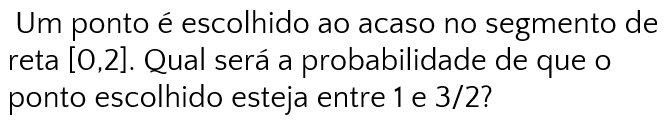
Considera um intervalo \([a, b]\) dentro do qual qualquer valor é igualmente provável.
Example
Suponha que o tempo de voo possa ser qualquer valor no intervalo entre 120 e 140 minutos; seja \(X\) a variável aleatória que representa o tempo de voo de uma aeronave viajando de Chicago a Nova York.
Função de probabilidade
Imagem de referência
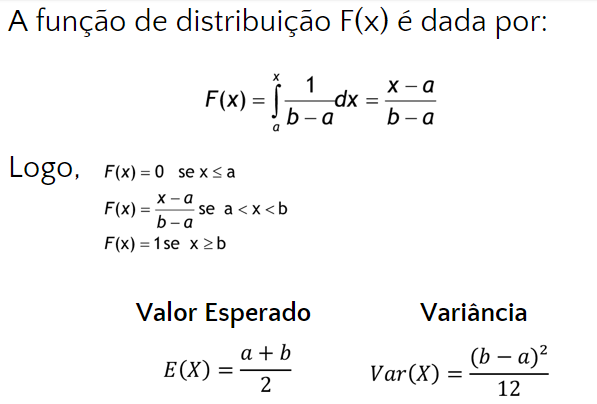
Gráfico
Imagem de referência
Example
Imagens de referência
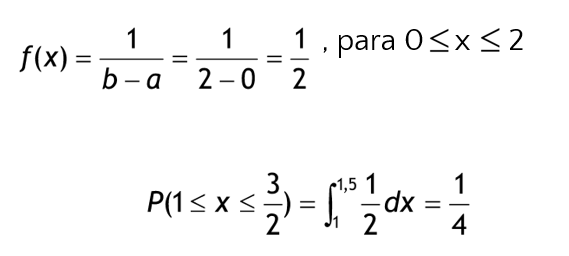
Distribuição exponencial
Útil para descrever o tempo necessário para completar uma tarefa.
Exemplos de aplicação
Tempo entre chegadas de pacotes em um roteador; tempo de vida de aparelhos; tempo de espera em restaurantes ou caixas de banco.
- Parâmetro: \(\lambda\) (média ou valor esperado).
- Está intimamente ligada à distribuição de Poisson (o tempo entre eventos de Poisson segue uma exponencial).
Função de probabilidade
Imagem de referência
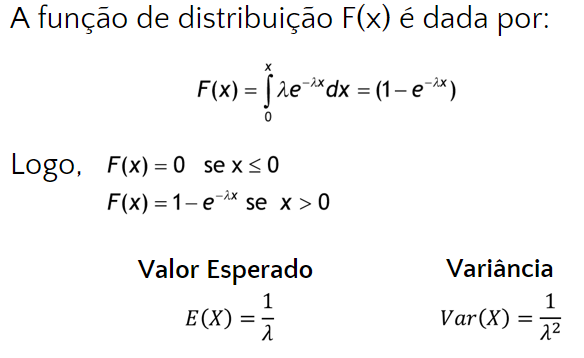
O \(\lambda\) aqui segue a mesma lógica do \(\lambda\) da distribuição de Poisson.
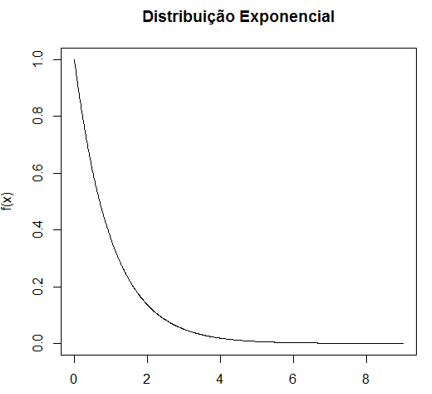
Gráfico
Imagem de referência
Example
Imagens de referência
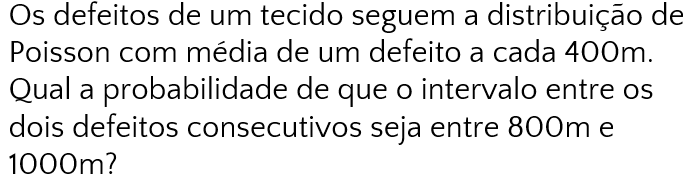
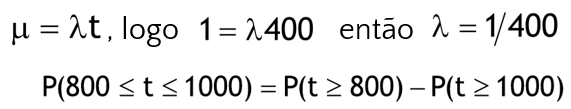
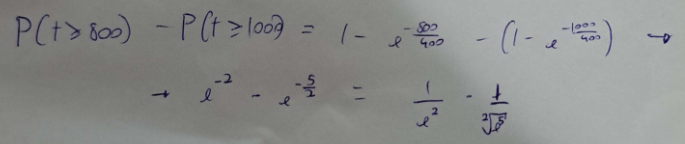
O resultado final é a soma de uma parte com a outra.
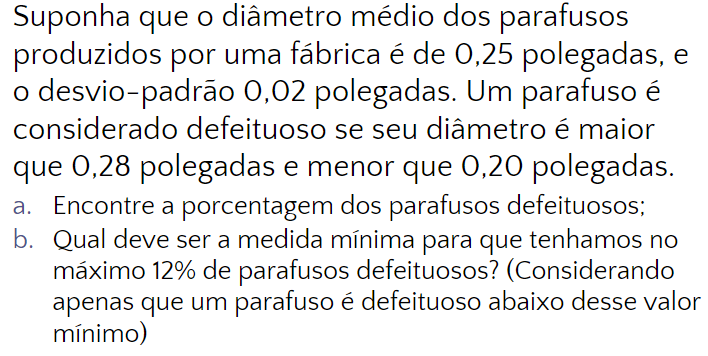
Distribuição normal
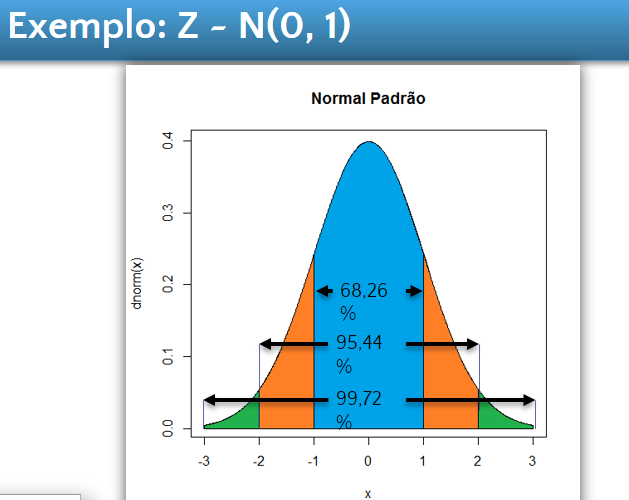
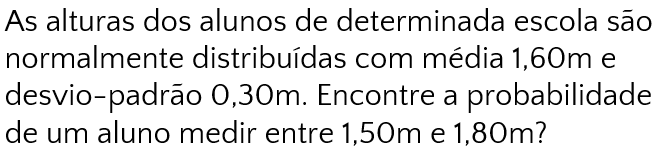
Usada em uma ampla variedade de aplicações práticas, para variáveis como altura, peso, medições e índices em geral.
- Parâmetros: \(\mu\) (média) e \(\sigma\) (desvio padrão).
Example
Os salários dos diretores de empresas em São Paulo se distribuem normalmente, com média de R$ 20.000,00 e desvio padrão de R$ 500,00.
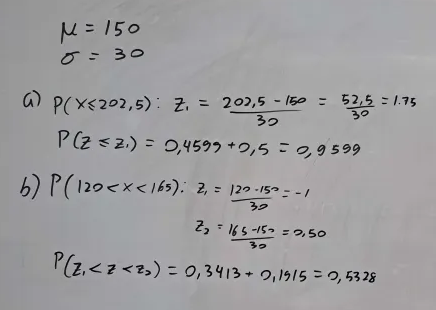
Função de probabilidade
Imagem de referência
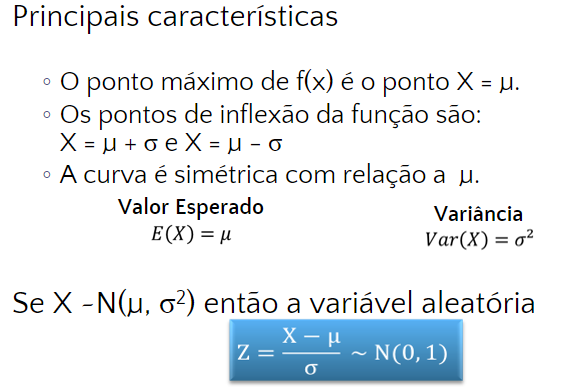
Gráfico
Imagem de referência
Example
Imagens de referência
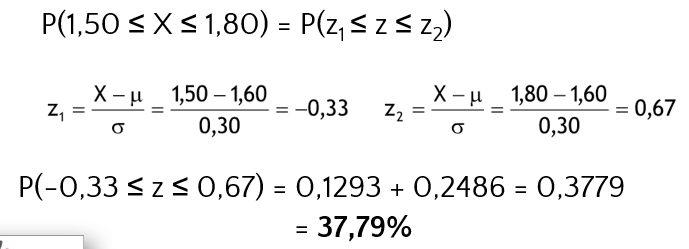
Exemplos (distribuições contínuas)
-
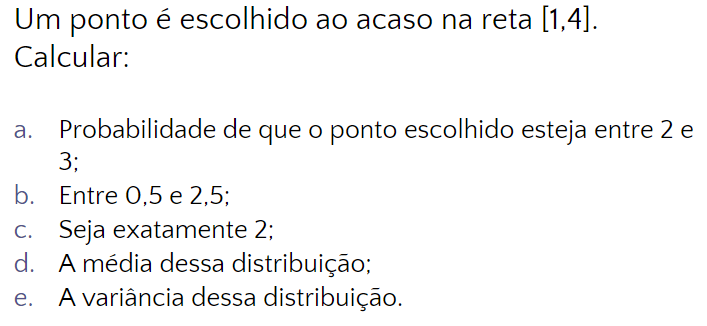
Imagem de referência
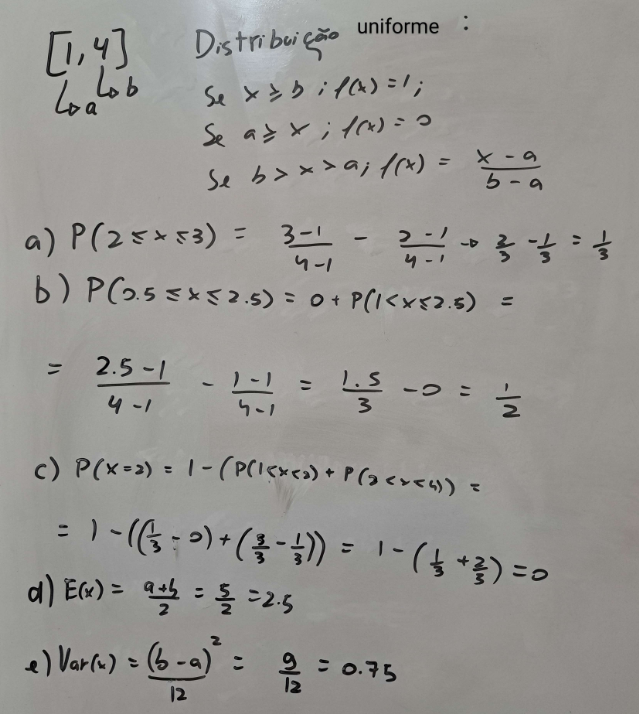
-
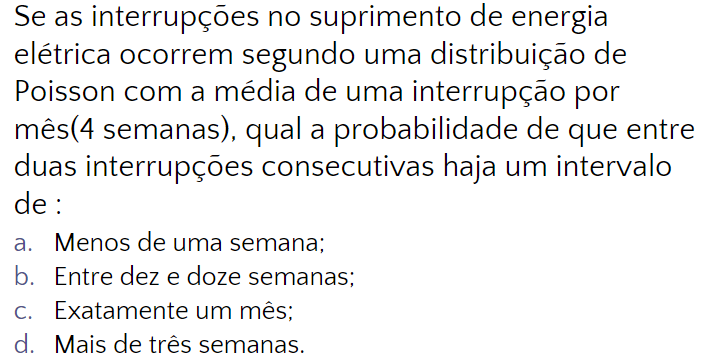
Imagem de referência
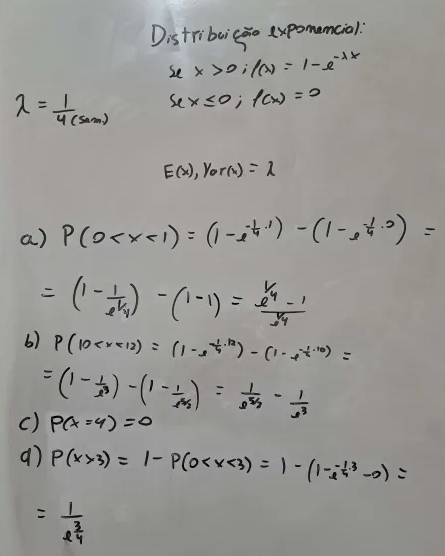
-
Imagens de referência
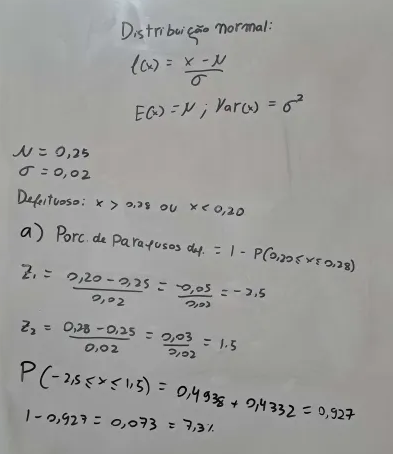
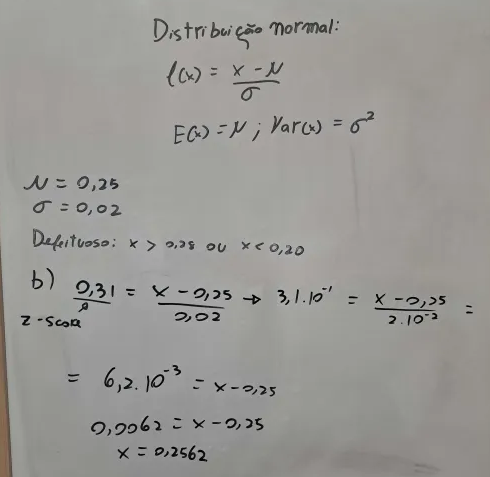
Observação:
0,31é o Z-Score correspondente a0,12na tabela da normal.
Exemplos gerais sobre distribuições
-
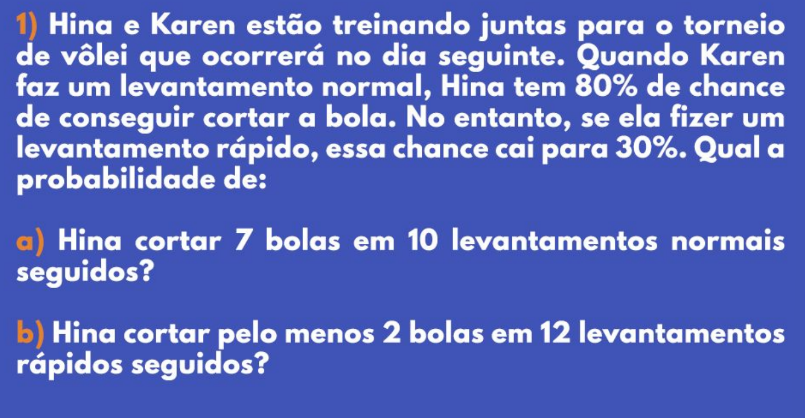
Imagem de referência
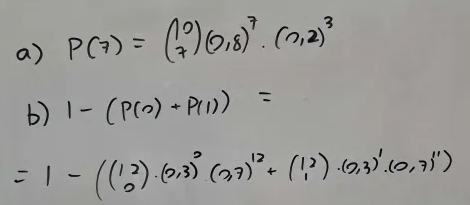
-
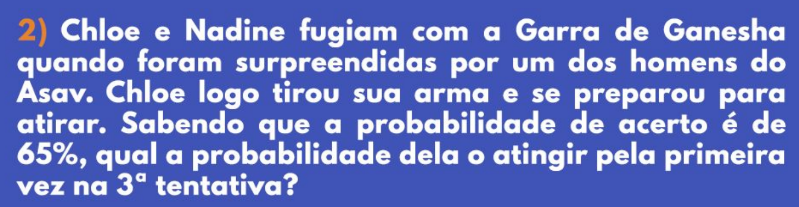
Imagem de referência
-
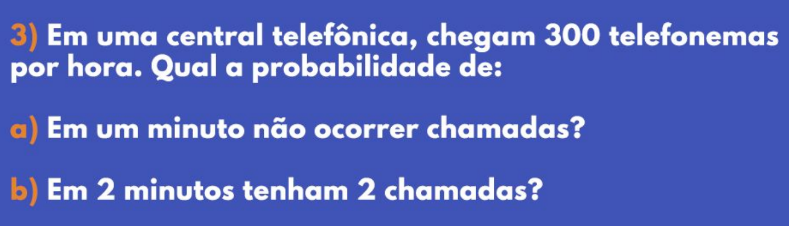
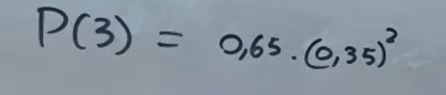
Imagem de referência
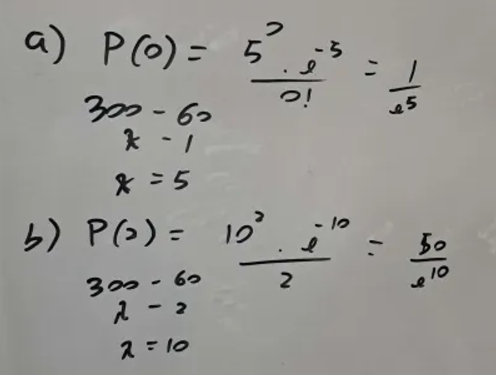
-
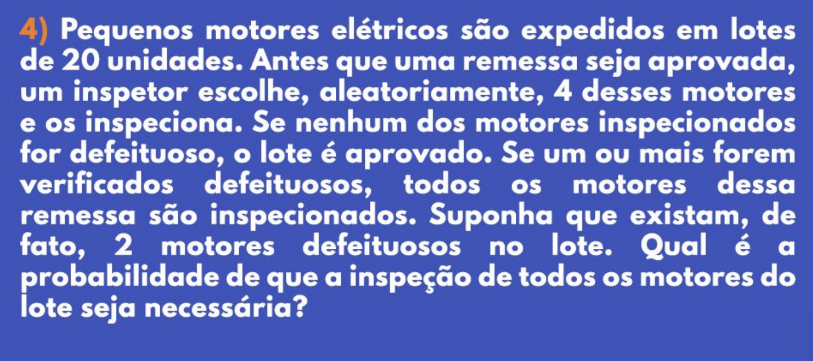
Imagem de referência
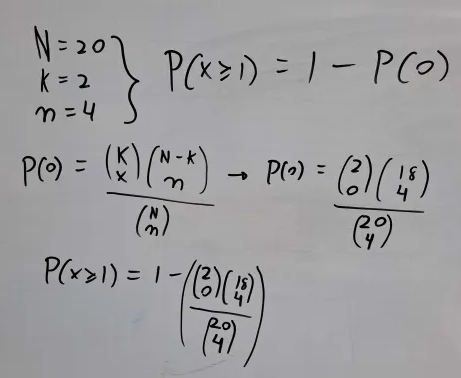
-
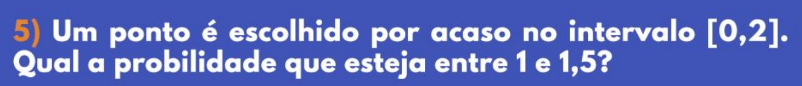
Imagem de referência
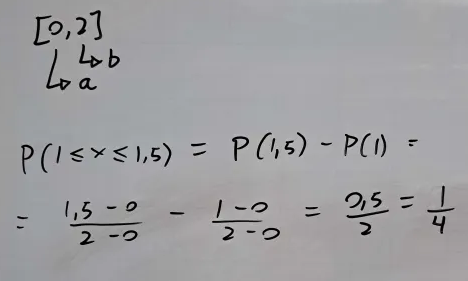
-
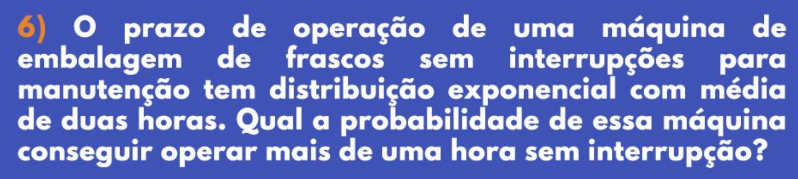
Imagem de referência
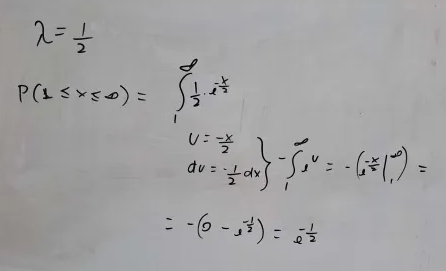
-
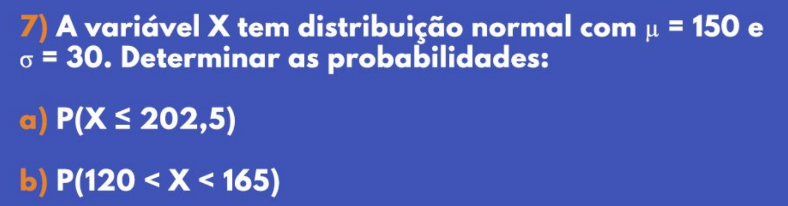
Imagem de referência
Análise exploratória
Tabela estatística
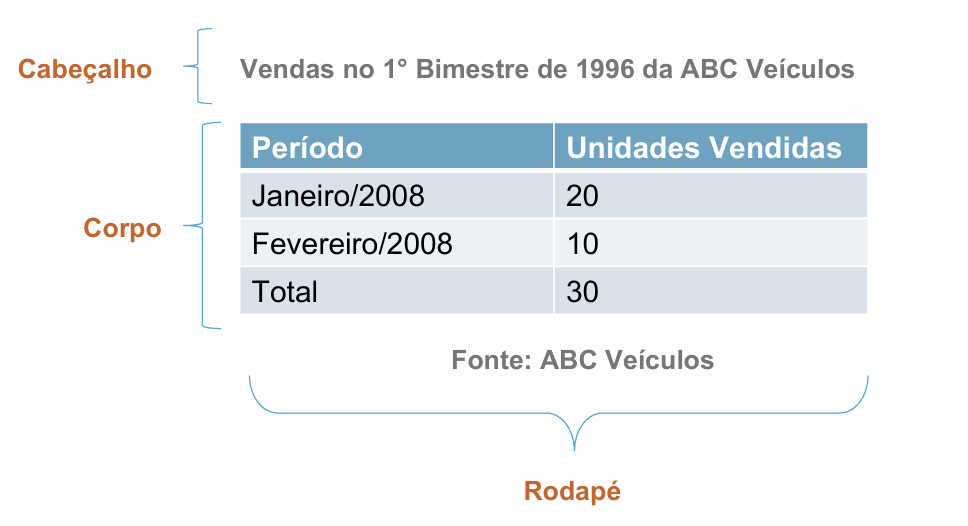
Toda tabela estatística deve ter: cabeçalho (breve descrição do propósito), corpo (os registros de dados) e rodapé (fonte dos dados).
Example
Imagem de referência
Séries estatísticas
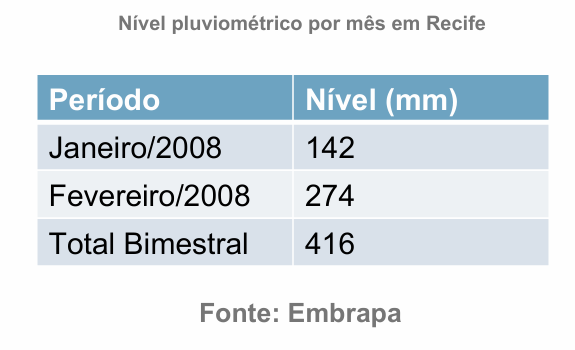
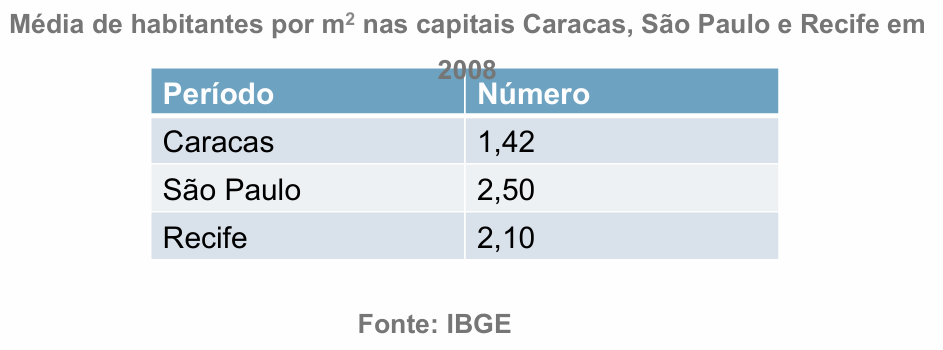
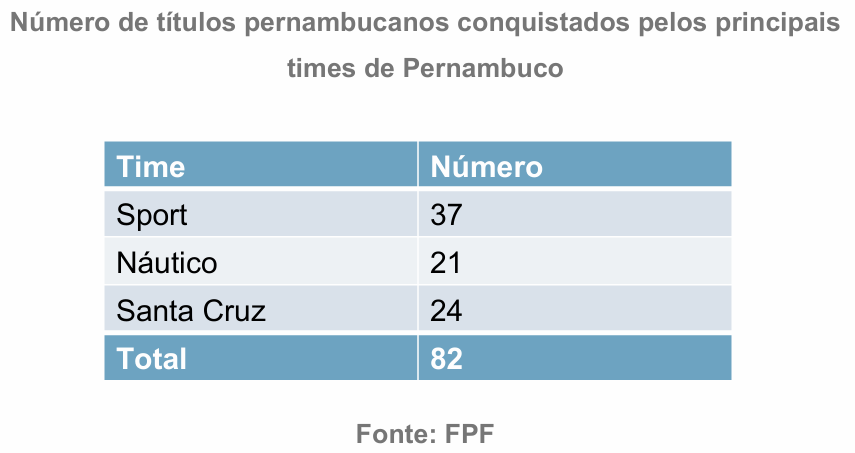
Uma série estatística é qualquer tabela que apresenta a distribuição de um conjunto de dados em função da época (fator temporal), do local (onde o fenômeno ocorre) ou da espécie (o fato/fenômeno em si).
| Tipo | Fator variável | Fatores fixos |
|---|---|---|
| Temporal (cronológica) | Época | Local e espécie |
| Geográfica (histórica) | Local | Época e espécie |
| Específica (categórica) | Espécie | Época e local |
Série temporal
Imagem de referência
Série geográfica
Imagem de referência
Série específica
Imagem de referência
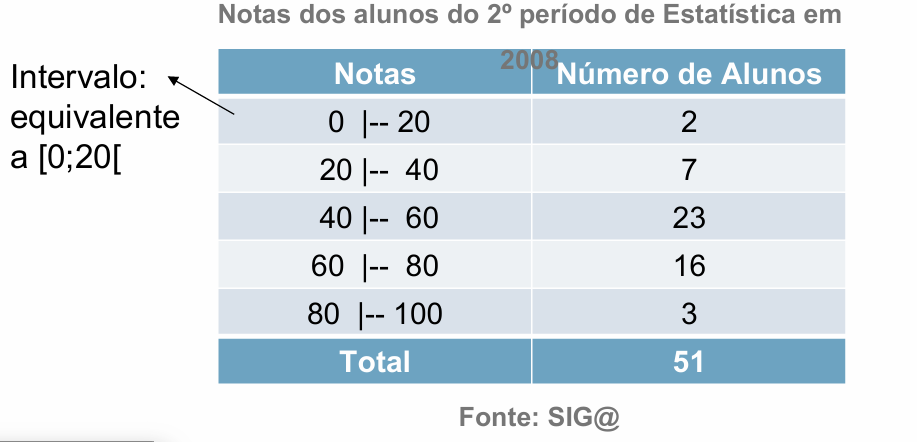
Distribuições de frequência — tabela em que os valores da variável não aparecem individualmente, mas agrupados em classes.
Imagem de referência
População e amostra
- População — conjunto de elementos que compartilham uma determinada característica. Pode ser finita ou infinita (algumas populações finitas são tratadas como infinitas para fins práticos).
- Amostra — qualquer subconjunto não vazio da população, com número de elementos menor que o da população.
Imagem de referência
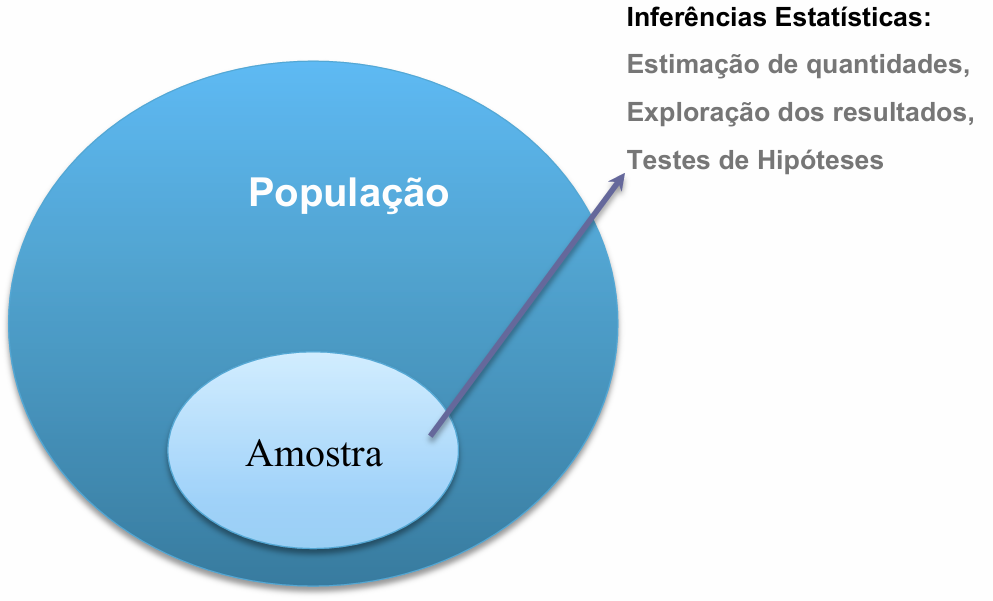
A escolha de como selecionar a amostra depende, entre outros fatores, do grau de conhecimento sobre a população e dos recursos disponíveis. O objetivo é que a amostra seja o mais representativa possível da população de origem.
Tipos de amostragem
-
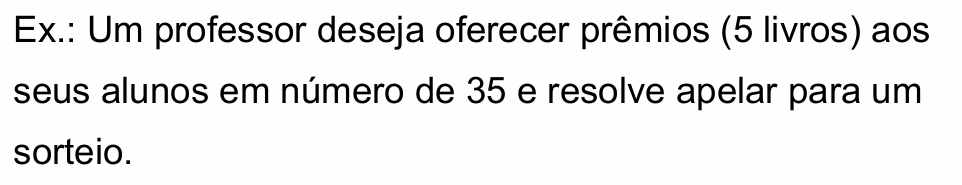
Amostragem aleatória — cada elemento é retirado aleatoriamente de toda a população (com ou sem reposição); toda amostra possível tem a mesma probabilidade de ser selecionada.
Imagem de referência
-
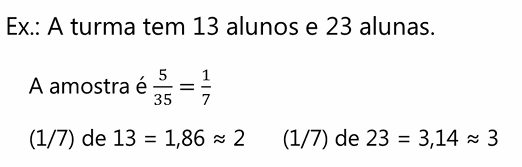
Amostragem estratificada — subdivide a população em pelo menos dois grupos (estratos) que compartilham alguma característica, e depois coleta uma amostra de cada estrato (tipicamente por amostragem aleatória dentro de cada um).
Imagem de referência
-
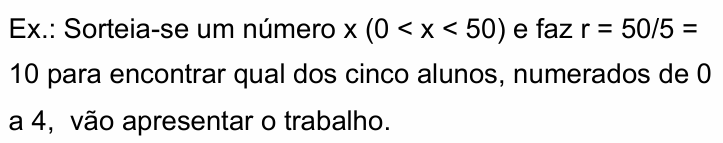
Amostragem sistemática — usada quando os elementos da população já estão ordenados, e a retirada ocorre periodicamente (por exemplo, a cada \(k\)-ésimo elemento).
Imagem de referência
Variável (estatística)
Uma variável é uma característica observável nos elementos da população, com pelo menos um resultado possível para cada elemento observado.
-
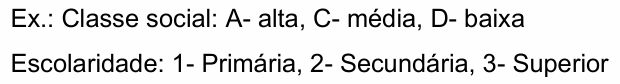
Qualitativa — o resultado é um atributo ou qualidade.
-
Ordinal — admite uma ordenação natural entre as categorias.
Imagem de referência
-
Nominal — não existe ordenação entre as categorias.
Imagem de referência

-
-
Quantitativa — o resultado é um número em uma escala pré-determinada.
- Discreta — resultados possíveis são números inteiros (ex.: número de alunos).
- Contínua — o resultado está em um intervalo dos números reais (ex.: atraso de transmissão de bytes em uma rede).
Gráficos
Gráficos representam resultados obtidos, permitindo tirar conclusões sobre a evolução de um fenômeno ou sobre como se relacionam os valores de uma série.
-
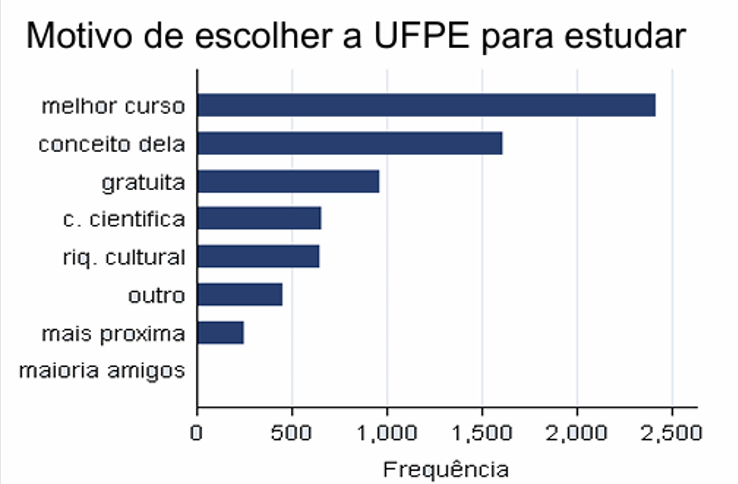
Gráfico de barras (barras horizontais):
Imagem de referência
-
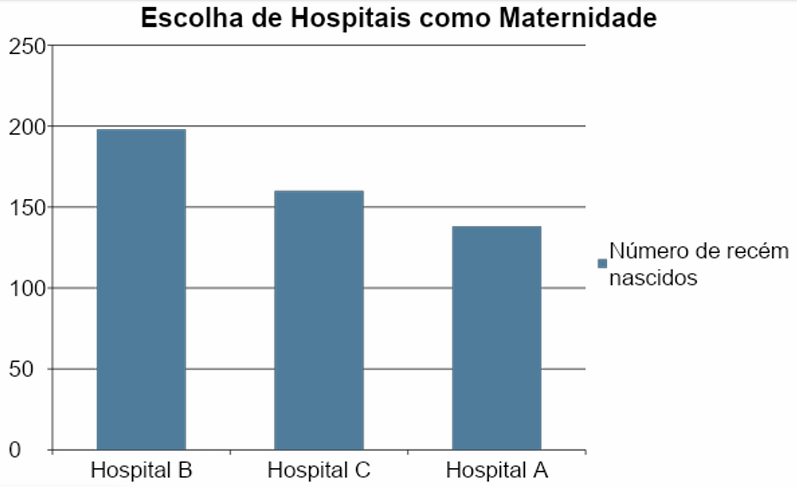
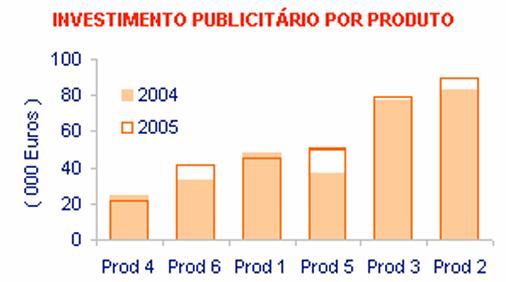
Gráfico de colunas (barras verticais), útil para mostrar alterações ao longo do tempo ou comparar itens:
Imagens de referência
-
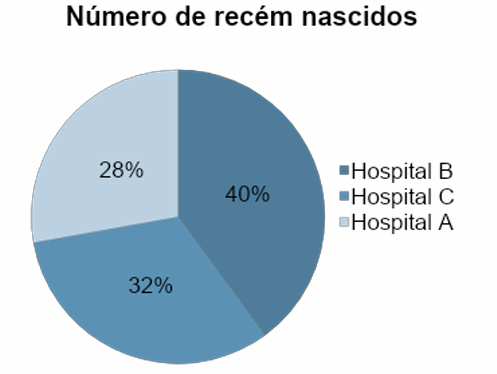
Gráfico de setor (pizza), útil para mostrar a importância relativa de proporções, trabalhando com porcentagens:
Imagem de referência
-
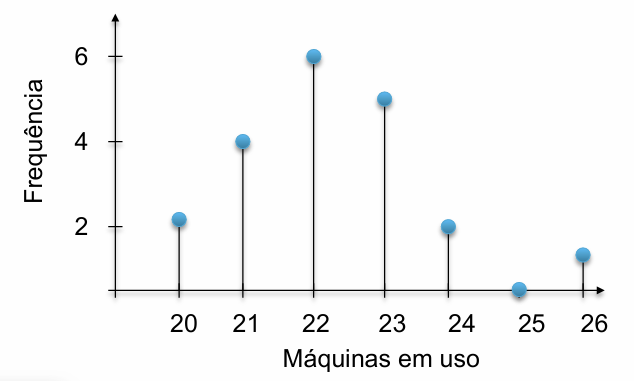
Gráfico de hastes:
Imagem de referência
-
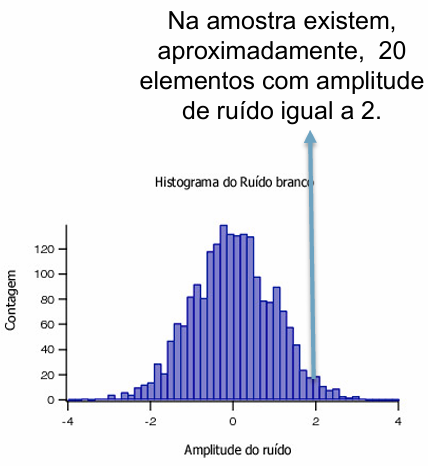
Histogramas — representação gráfica de uma distribuição de frequências por meio de retângulos justapostos.
Example
Imagem de referência
Distribuição de frequência
O método mais útil para descrever os resultados de uma variável é a distribuição de frequência: uma tabela em que os valores não aparecem individualmente, mas agrupados em classes.
Cuidado ao escolher o número de classes
- Com muitos intervalos, corremos o risco de não realçar aspectos relevantes (ruído em excesso).
- Com poucos intervalos, os grupos ficam muito abrangentes, impedindo maior precisão.
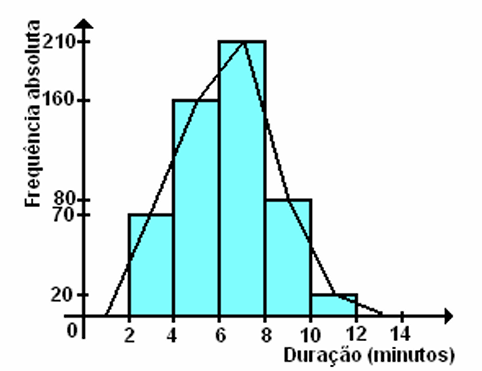
Polígono de frequências — representação gráfica da distribuição de frequências, usando os pontos médios dos intervalos de classe, conectados por segmentos de linha.
Example
Imagem de referência
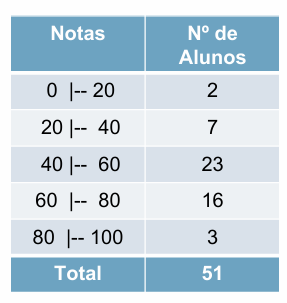
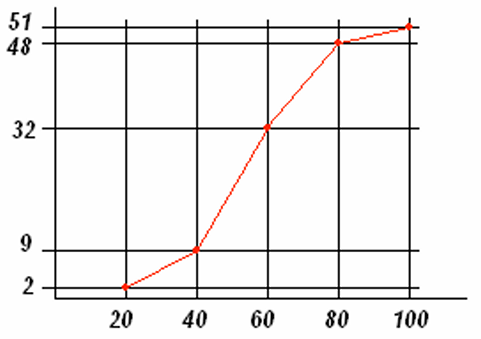
Polígono de frequência acumulada — cada ponto do gráfico representa a soma de todas as frequências das classes anteriores, mais a frequência da classe correspondente ao ponto.
Example
Tabela:
Imagem de referência
Polígono de frequência acumulada:
Imagem de referência
Como construir uma tabela de distribuição de frequência
Passo a passo
Imagem de referência
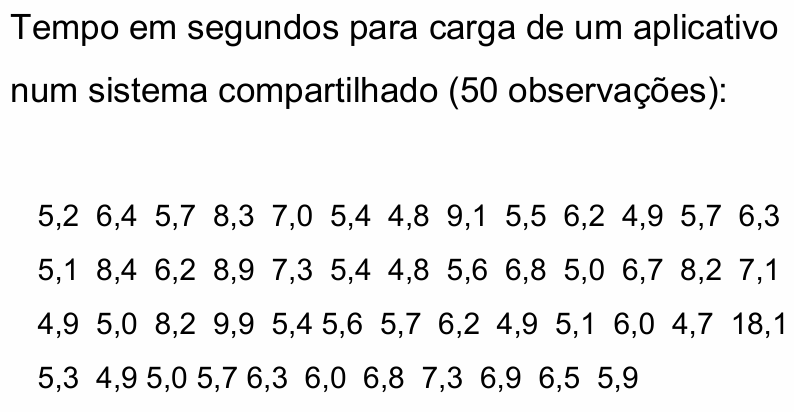
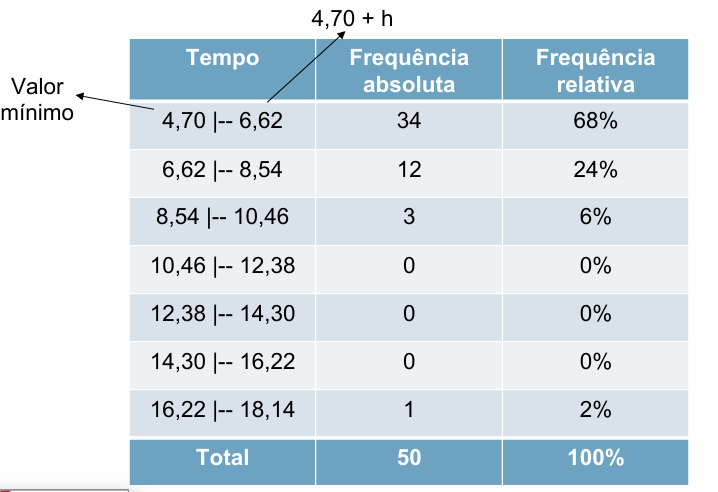
1º passo — determinar a amplitude total: maior valor menos menor valor. Nesse caso, \(18{,}1 - 4{,}7 = 13{,}4\).
2º passo — estimar o número de intervalos. Dois métodos comuns:
- Seja \(n\) o número de observações: para \(n > 25\), \(K = \sqrt{n}\); para \(n \leq 25\), \(K = 5\). Nesse exemplo, \(K = \sqrt{50} \approx 7{,}07\).
- Fórmula de Sturges: \(K = 1 + 3{,}22 \log n\). Nesse caso, \(K = 1 + 3{,}22 \log 50 \approx 7\).
Dada a importância de escolher um número razoável de intervalos, vamos com \(K = 7\).
3º passo — estimar a amplitude dos intervalos: dividimos a amplitude total pelo número de intervalos. Nesse caso, \(h = 13{,}4 / 7 = 1{,}914 \approx 1{,}92\).
4º passo — esquematizar a tabela de acordo com as informações anteriores:
Imagem de referência
Diagramas de dispersão — usados para identificar se existe correlação (forte, fraca, moderada, positiva, negativa) entre duas variáveis.
Imagem de referência
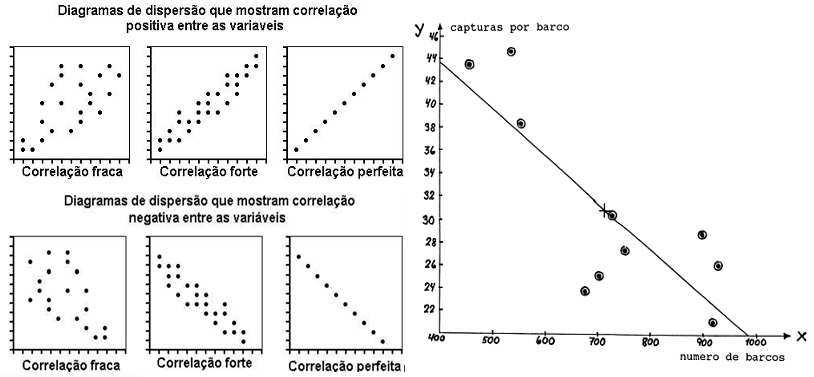
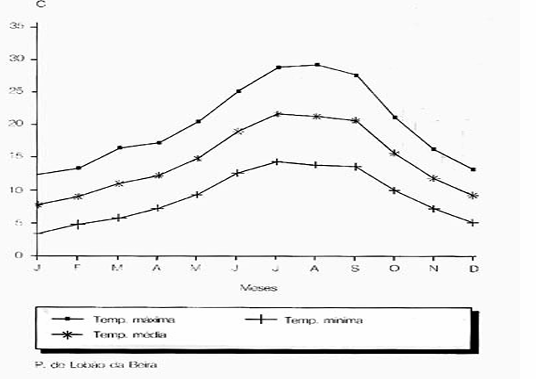
Gráfico de curvas — usado em processos para acompanhar a evolução de uma variável em relação a um ou mais limites existentes.
Imagem de referência
Considerações sobre a escolha do gráfico
Gráficos setoriais (pizza) são particularmente úteis para visualizar diferenças entre poucas classes, mas não acomodam bem muitas categorias. Nesse caso, é melhor reagrupar as categorias menos importantes em um grupo "outros", ou usar um gráfico de barras com as categorias separadas.
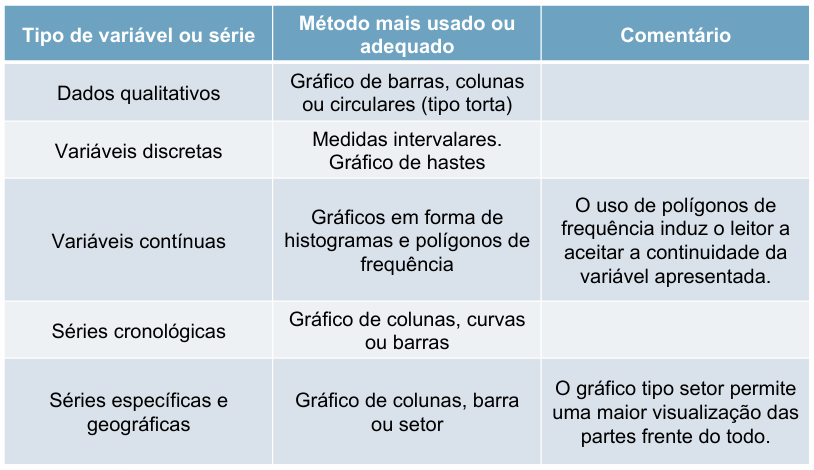
Melhores gráficos para cada tipo de dado
Imagem de referência
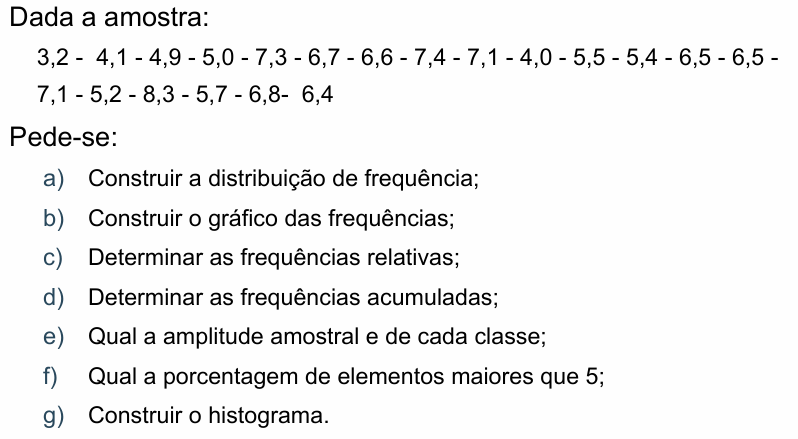
Exercício
Imagem de referência
Medidas estatísticas descritivas
Ferramentas básicas para medir e descrever características de um conjunto de dados.
Medidas de posição central
Representam um fenômeno pelo seu valor "médio" — o valor em torno do qual os dados tendem a se concentrar.
Média
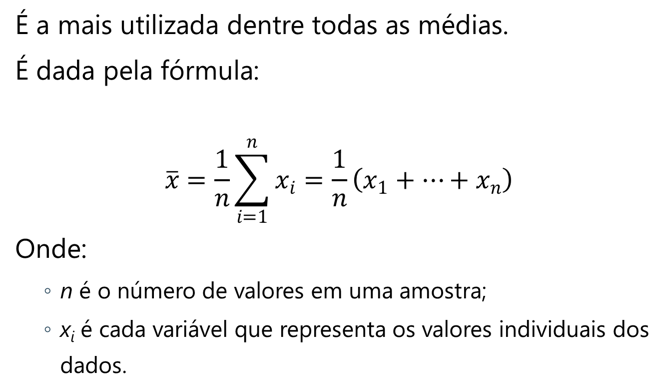
É o valor médio de uma distribuição, calculado segundo uma regra fixada a priori, usado para representar o conjunto de valores. Representada por \(\bar{x}\).
Imagem de referência
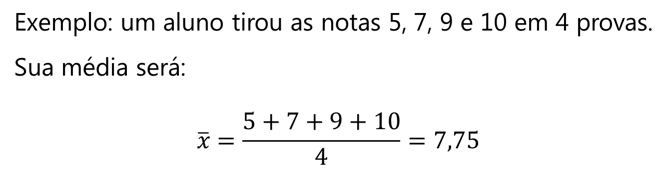
Example
Imagem de referência
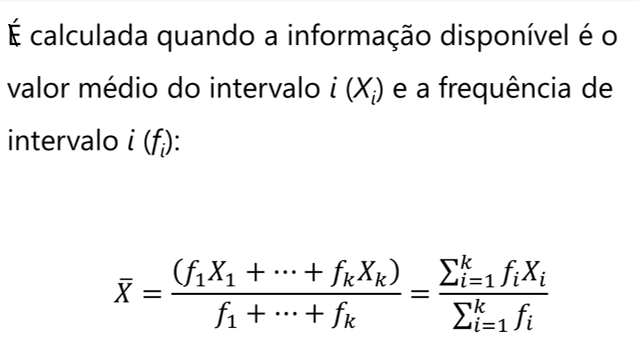
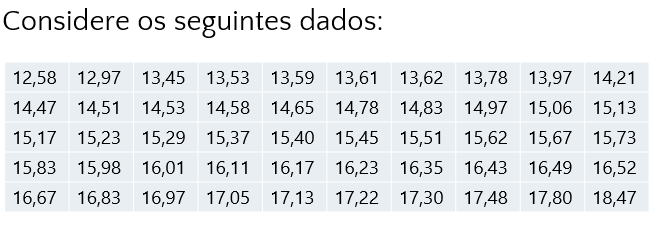
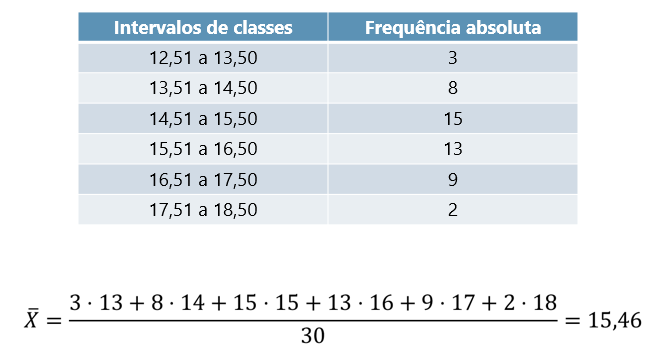
Para dados agrupados:
Imagem de referência
Example
Imagens de referência
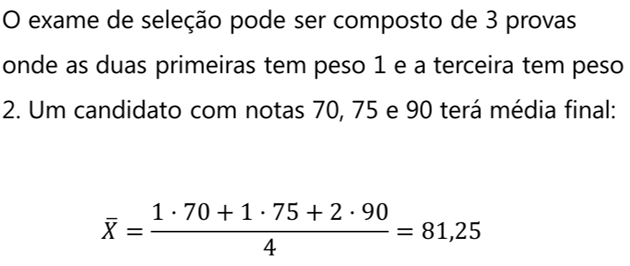
É uma média aritmética em que cada ocorrência tem um peso específico.
Imagem de referência
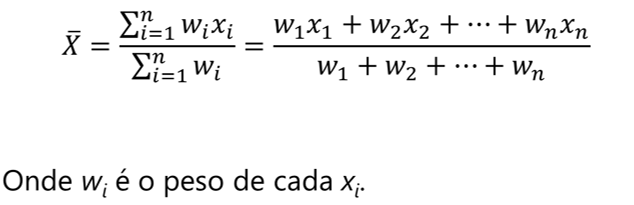
Example
Imagem de referência
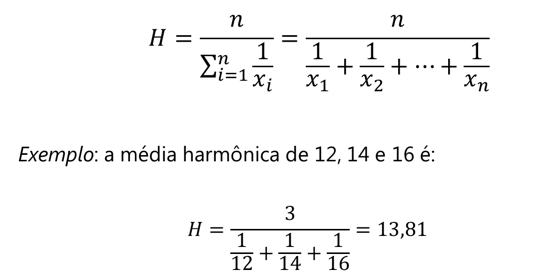
Equivale ao inverso da média aritmética dos inversos de \(n\) valores.
Imagem de referência
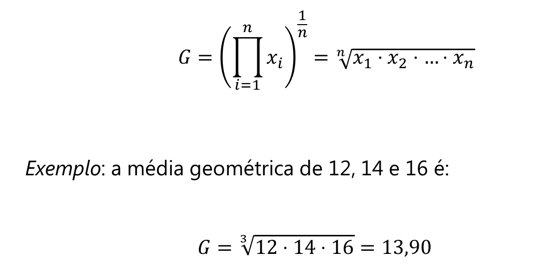
É a raiz de ordem \(n\) do produto dos valores da amostra.
Imagem de referência
Relação entre as médias
As médias geométrica e harmônica são sempre menores ou, no máximo, iguais à aritmética. A igualdade só ocorre quando todos os valores da amostra são idênticos. Quanto maior a variabilidade dos dados, maior a diferença entre a média aritmética e as médias harmônica/geométrica.
Example
Imagem de referência
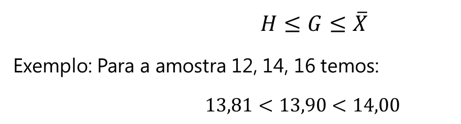
Mediana
É o valor que, com os dados ordenados, separa a metade inferior da amostra da metade superior.
-
Se \(n\) é ímpar, a mediana é o valor central:
Imagem de referência
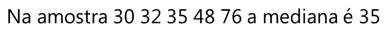
-
Se \(n\) é par, a mediana é a média simples dos dois valores centrais:
Imagem de referência
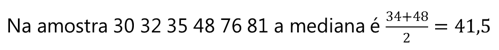
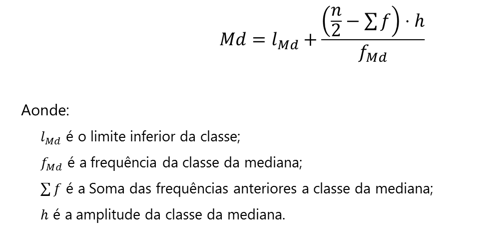
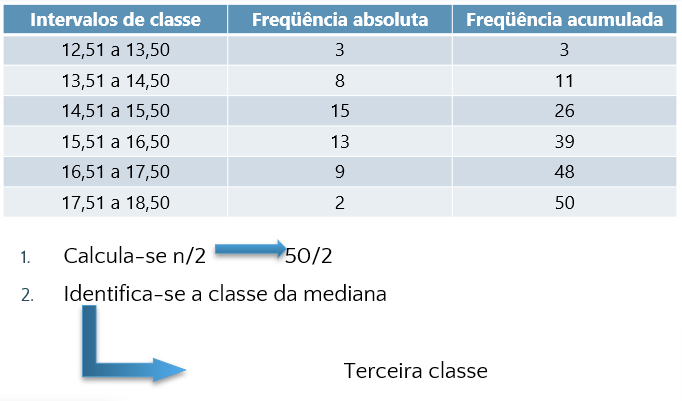
Para dados agrupados: calcula-se \(n/2\), identifica-se em qual classe esse valor se encontra (a partir das frequências acumuladas), e aplica-se a fórmula:
Imagem de referência
Example
Imagens de referência
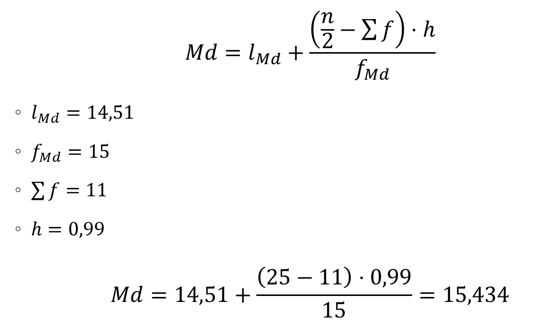
Moda
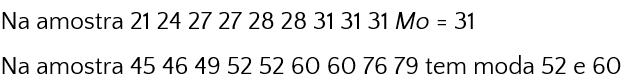
É o valor que ocorre com maior frequência; numa amostra, a moda pode não existir, ou pode ser múltipla (amostra multimodal).
Example
Imagem de referência
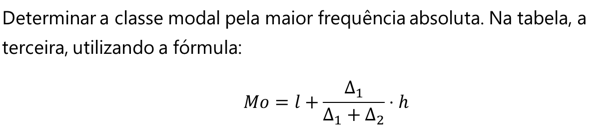
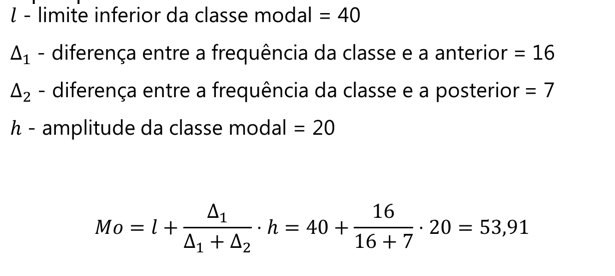
Moda para dados agrupados — usa-se a fórmula de King:
Imagem de referência
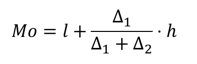
Onde:
- \(l\) — limite inferior da classe modal.
- \(\Delta_1\) — diferença entre a frequência da classe modal e a da classe anterior.
- \(\Delta_2\) — diferença entre a frequência da classe modal e a da classe posterior.
- \(h\) — amplitude da classe modal.
Example
Imagens de referência
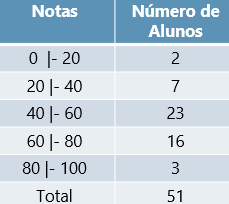
Medidas de dispersão
Quantificam o quanto os valores da amostra estão afastados (dispersos) em relação à média amostral.
Amplitude total — diferença entre o maior e o menor valor do conjunto de dados.
Example
Imagem de referência
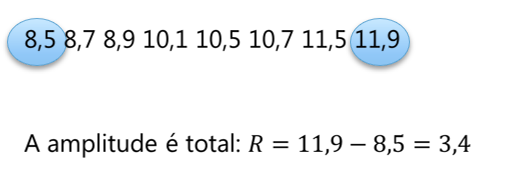
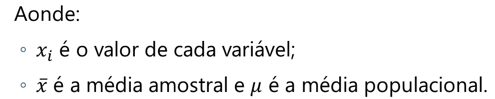
Desvio padrão — mede a dispersão dos valores em torno da média. Representado por \(s\) (amostral) e \(\sigma\) (populacional).
-
Para uma população de \(N\) indivíduos:
Imagem de referência
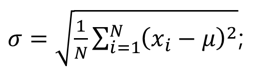
-
Para uma amostra de \(n\) observações:
Imagem de referência
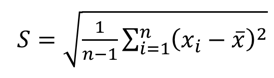
Imagem de referência
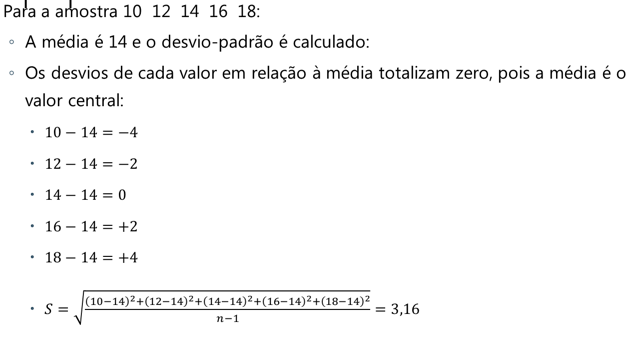
Example
Imagem de referência
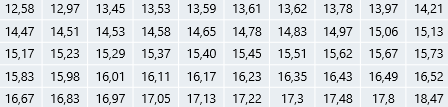
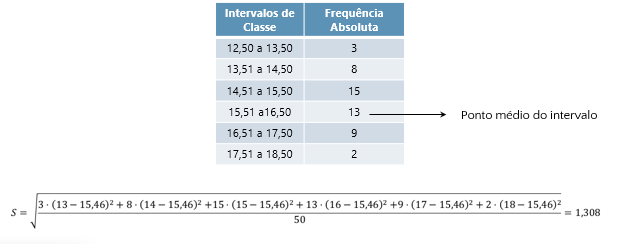
Dados agrupados — usa-se a mesma fórmula, mas cada termo do somatório é ponderado pela frequência absoluta da classe, e \(x_i\) passa a ser o ponto médio (a "média") da classe.
Example
Imagens de referência
Coeficiente de variação — para um conjunto de dados amostrais ou populacionais, expresso como percentual, descreve o desvio padrão relativo à média:
Imagem de referência
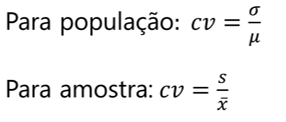
É uma medida adimensional, útil para comparar a dispersão de amostras/populações em unidades diferentes. Desvantagem: perde utilidade quando a média está próxima de zero.
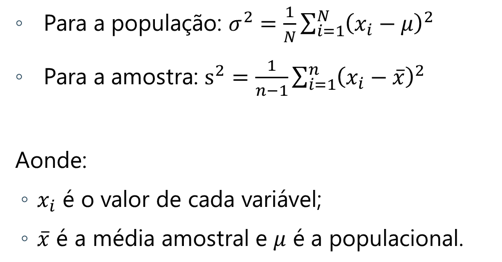
Variância — medida de dispersão igual ao quadrado do desvio padrão:
Imagem de referência
Warning
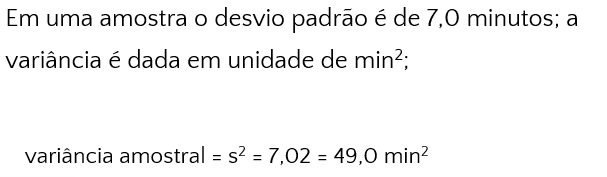
A variância não é expressa nas mesmas unidades dos dados originais (é o quadrado da unidade original), o que dificulta sua interpretação direta.
Example
Imagem de referência
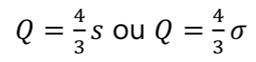
Amplitude interquartílica — amplitude do intervalo entre o primeiro e o terceiro quartil, representada por \(IQ\) (ou \(Q\)):
Imagem de referência
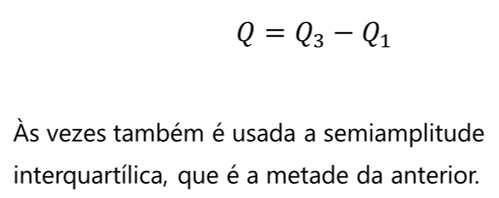
É uma medida de variabilidade robusta, pouco afetada por dados atípicos (outliers); tem relação com o desvio padrão:
Imagem de referência
Medidas de posição (separatrizes)
Dividem a área de uma distribuição de frequência em regiões de áreas iguais.
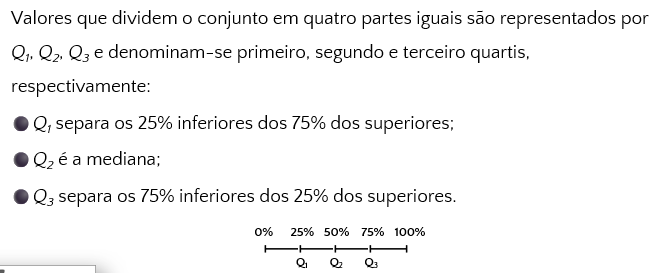
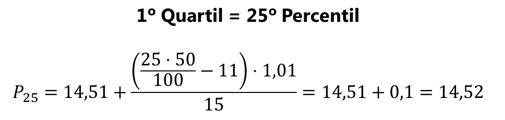
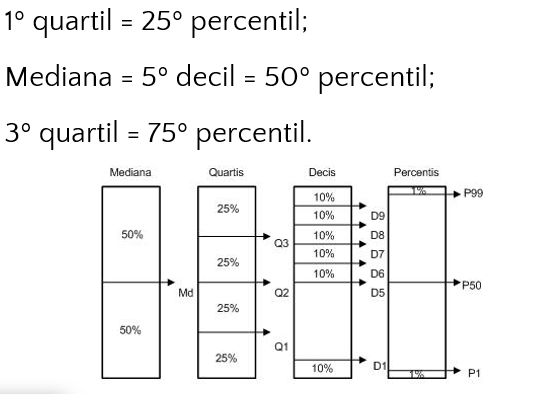
Quartil — qualquer um dos três valores que divide o conjunto ordenado de dados em 4 partes iguais; cada parte representa \(1/4\) da amostra ou população.
Imagem de referência
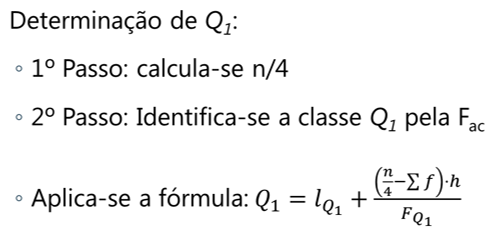
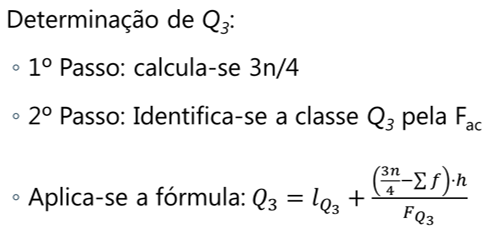
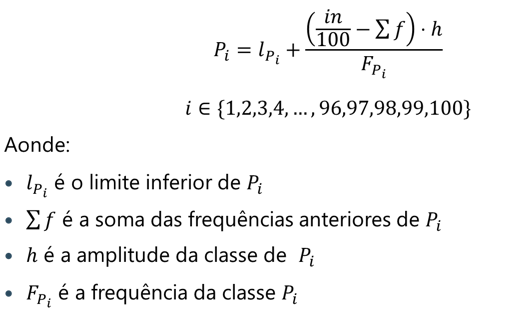
Para dados agrupados:
Imagens de referência
Percentil — divide o conjunto ordenado de dados em 100 partes iguais, cada parte representando \(1/100\) da amostra. O \(k\)-ésimo percentil \(P_k\) corresponde à frequência cumulativa de \(N \cdot k/100\), onde \(N\) é o tamanho amostral.
Imagem de referência
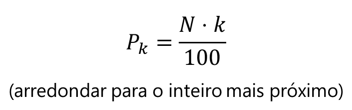
Para dados agrupados:
Imagem de referência
Example
Imagens de referência
Relações entre quartil e percentil
Imagem de referência
Medida de assimetria
Permite analisar uma distribuição a partir das relações entre moda, média e mediana — graficamente, ou apenas pelos valores numéricos. Uma distribuição é dita simétrica quando moda, média e mediana coincidem; caso contrário, é assimétrica.
Para calcular a assimetria, usa-se o coeficiente de assimetria de Pearson:
Imagem de referência
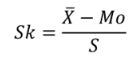
Onde \(\bar{x}\) é a média aritmética, \(M_o\) é a moda e \(s\) é o desvio padrão. O coeficiente assume valores entre \(-1\) e \(+1\).
Curvas assimétricas
-
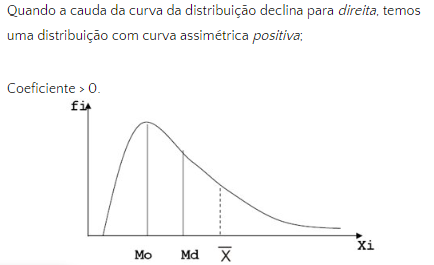
Coeficiente \(> 0\) (assimetria positiva, cauda à direita):
Imagem de referência
-
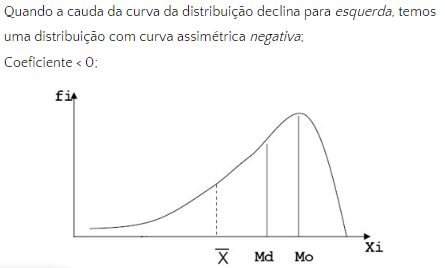
Coeficiente \(< 0\) (assimetria negativa, cauda à esquerda):
Imagem de referência
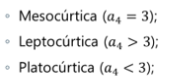
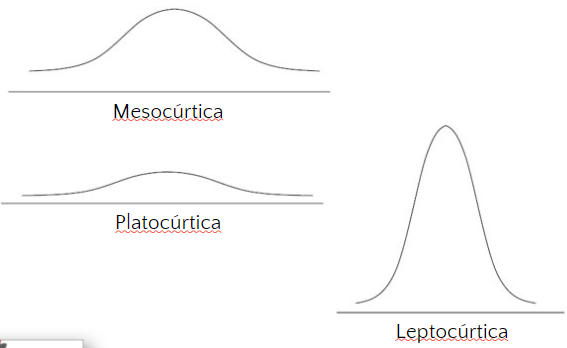
Curtose
Mede o grau de "achatamento" de uma distribuição em relação a uma curva normal de referência. Para calcular, usa-se o coeficiente de Pearson:
Imagens de referência
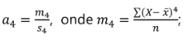
Exercícios
-
-
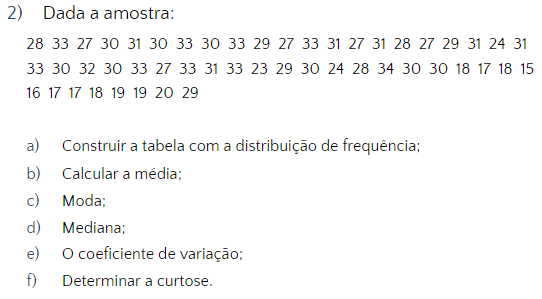
-
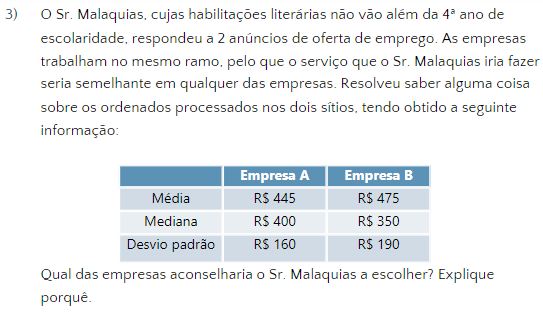
-
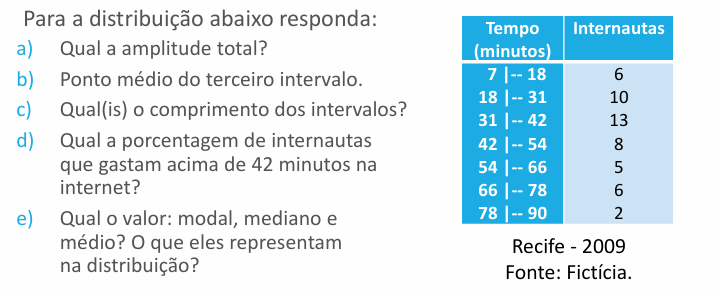
Imagem de referência
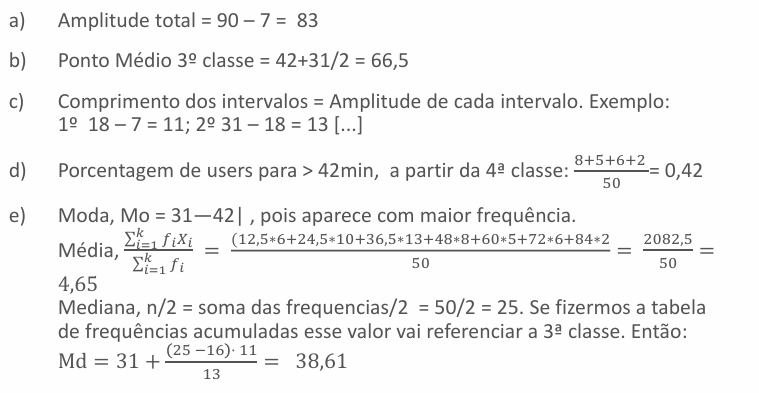
-
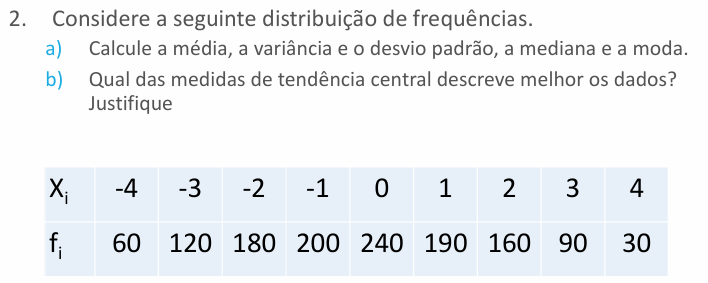
Imagens de referência
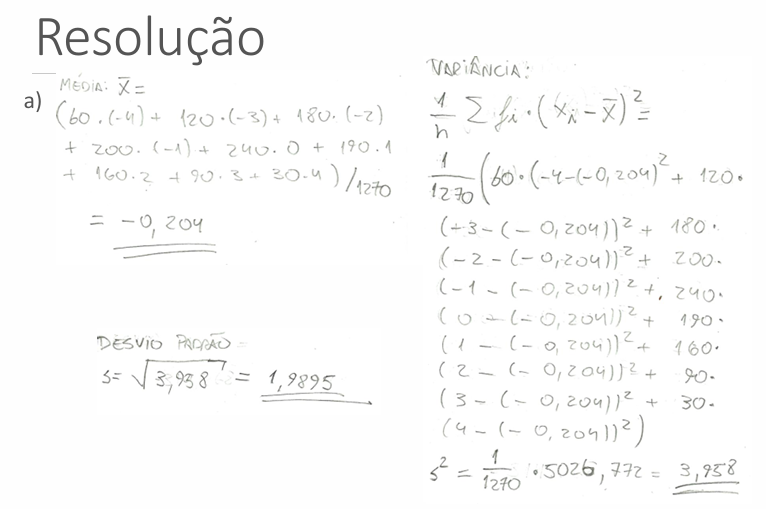
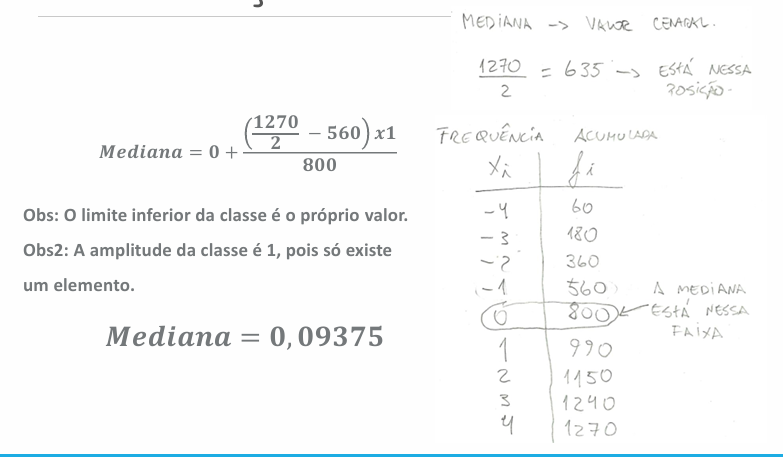
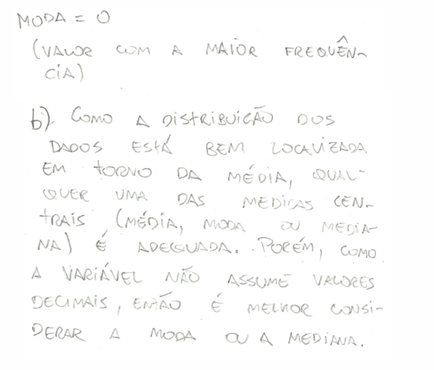
-
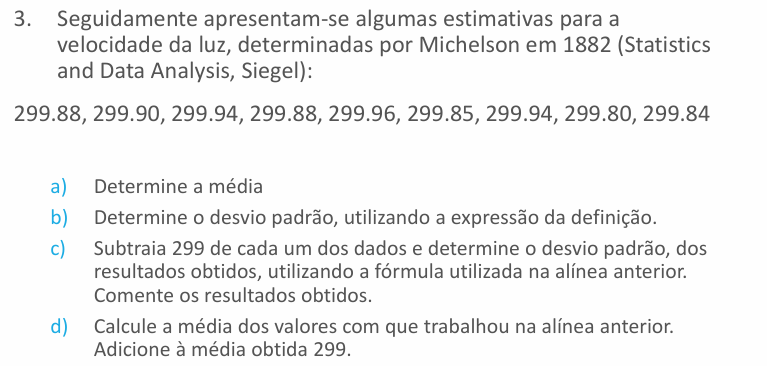
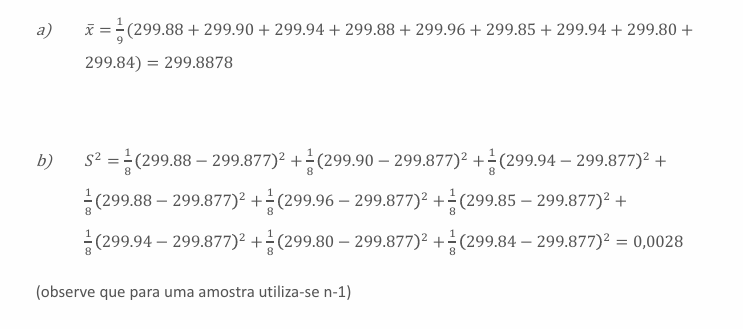
Imagens de referência
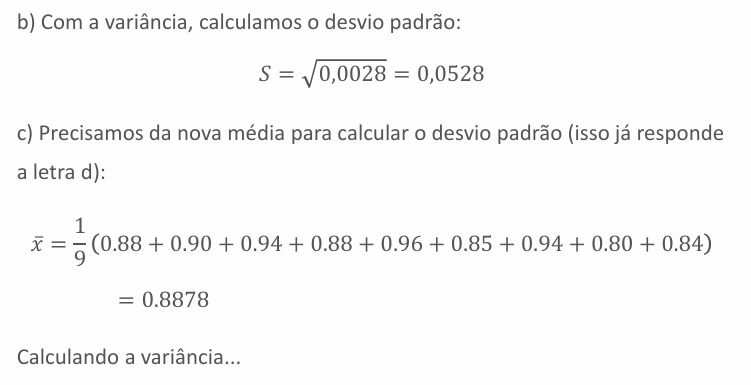
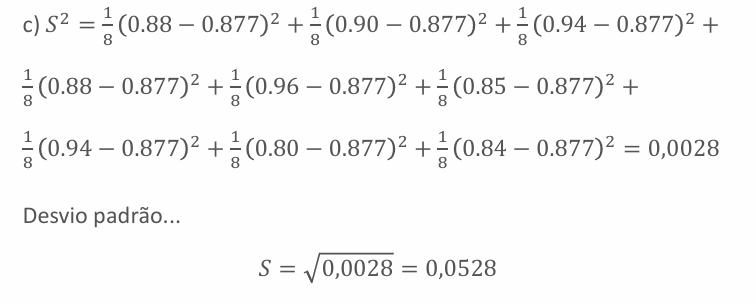
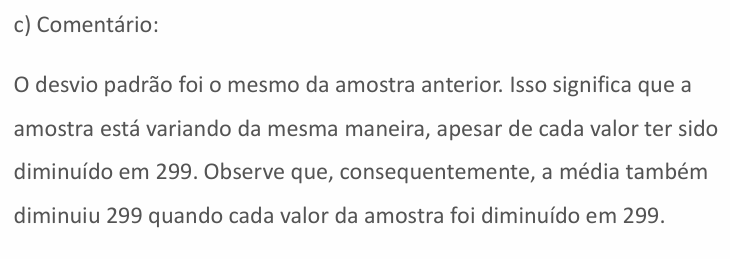
Exemplos adicionais
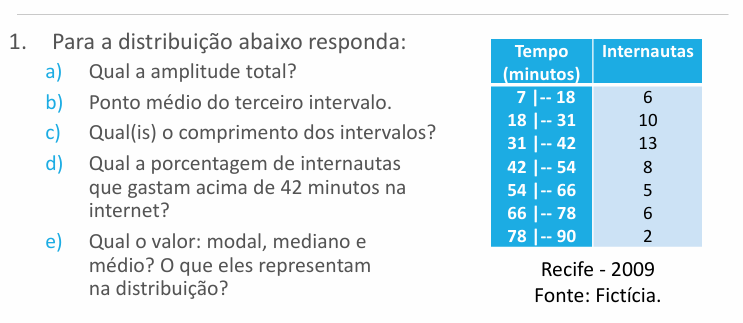
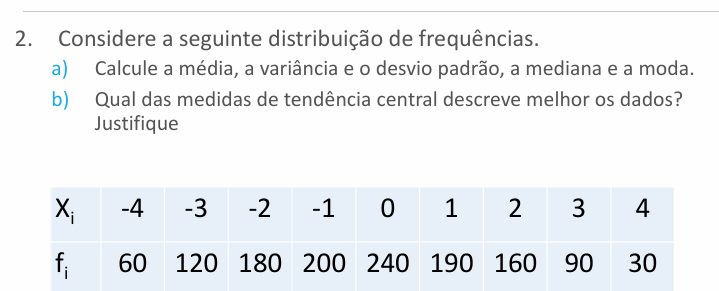
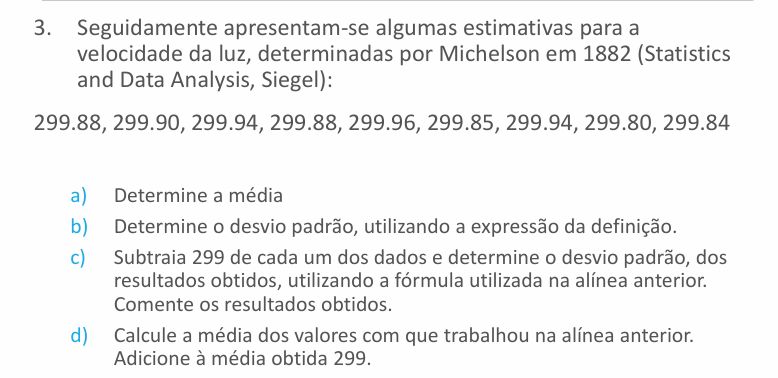
Estimação
Estatística descritiva vs. inferência estatística
A estatística descritiva tem por objetivo resumir ou descrever características importantes de dados populacionais ou amostrais já conhecidos. Já a inferência estatística é o processo de tirar conclusões (ou generalizações) sobre uma população, usando apenas informações de uma amostra dela.
Estimativa
Um estimador é uma estatística usada para obter uma aproximação de um parâmetro populacional.
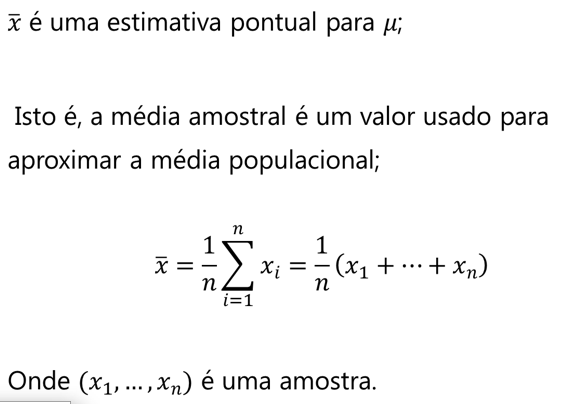
Estimativa pontual — um único valor usado para aproximar o parâmetro. A média amostral é a melhor estimativa pontual para a média populacional; a variância amostral, para a variância populacional.
Imagem de referência
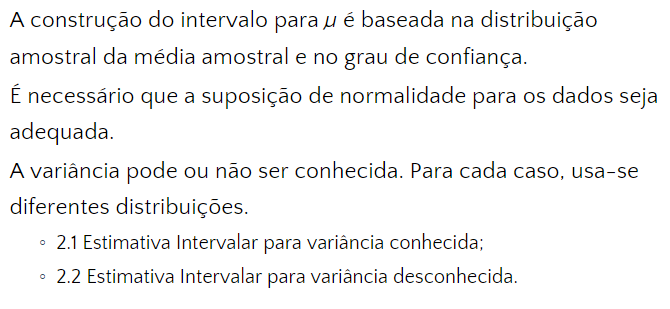
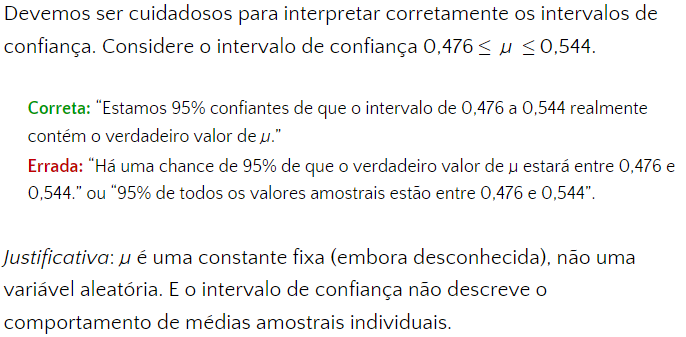
Estimativa intervalar — um intervalo de valores que contém a média da população com uma determinada probabilidade de acerto. O intervalo de confiança está associado a um grau de confiança, que mede o quão certos estamos de que o intervalo de fato contém o parâmetro populacional.
Imagem de referência
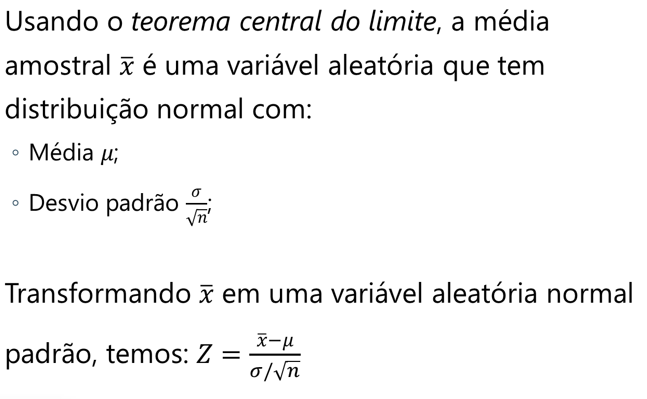
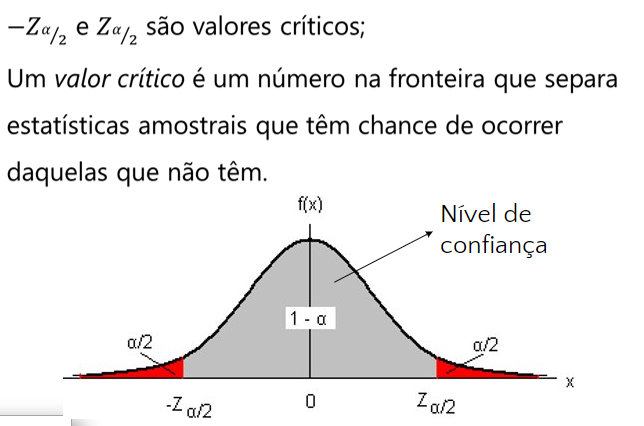
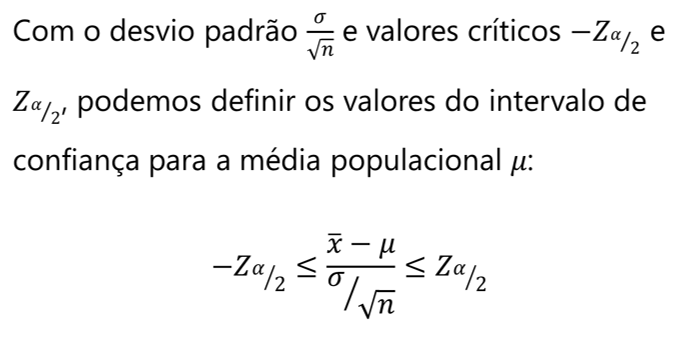
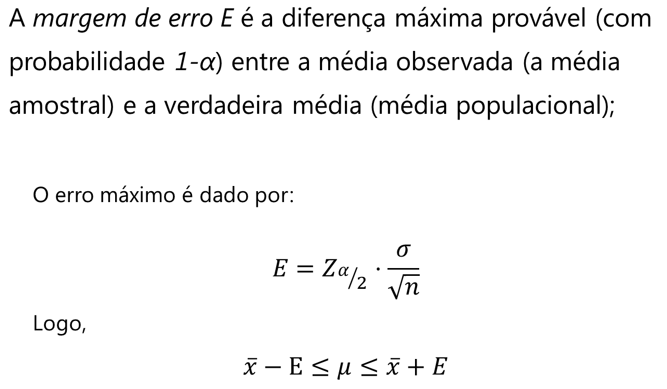
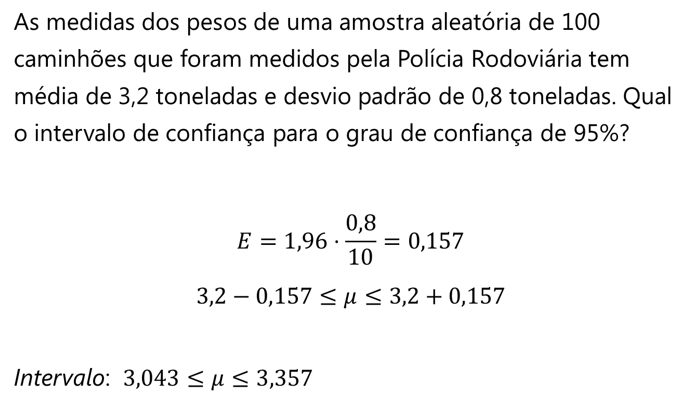
Variância conhecida (usa-se a distribuição normal):
Imagens de referência
Example
Imagem de referência
Variância desconhecida (usa-se a distribuição t-Student):
Imagem de referência
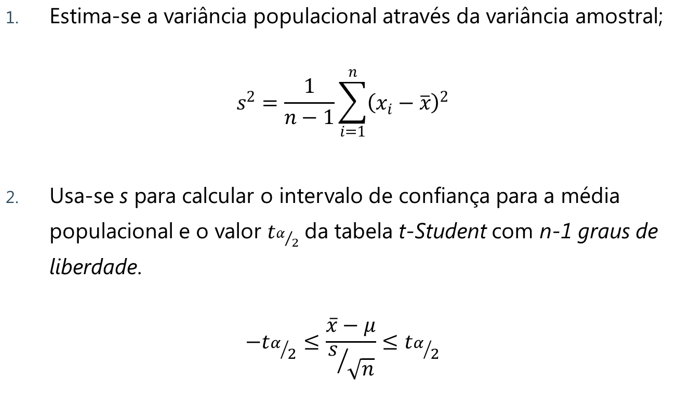
Grau de liberdade — o número de valores amostrais que podem variar livremente, depois que certas restrições são impostas aos dados.
Example
Imagens de referência
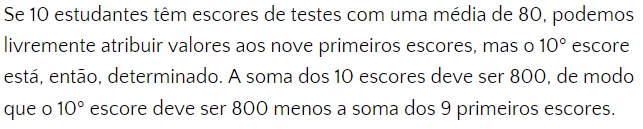
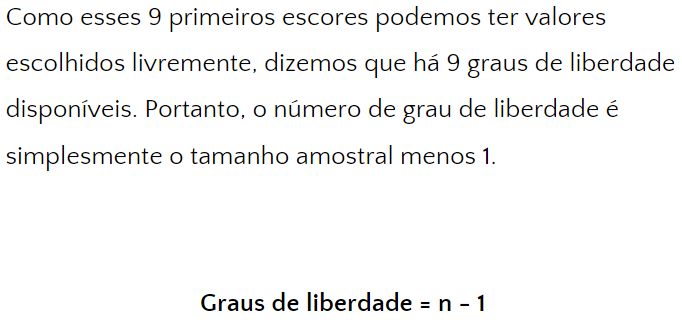
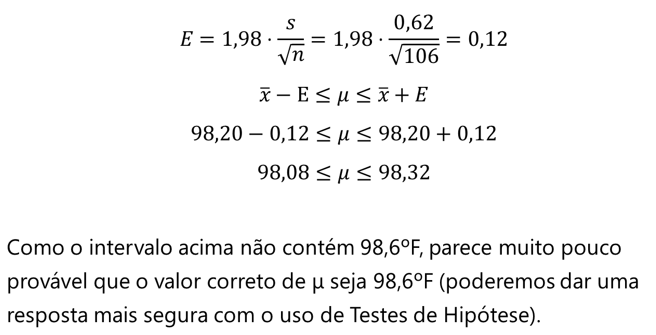
Com isso, o intervalo de confiança é \(\bar{x} - E \leq \mu \leq \bar{x} + E\), onde \(E\) é a margem de erro calculada pela fórmula do t-Student acima.
Intervalo de confiança (resumo)
Imagem de referência
Example
Imagens de referência
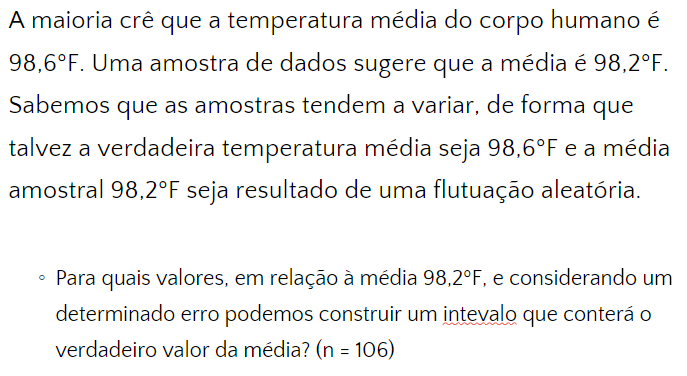
Exemplos
Teste de hipótese
Definição
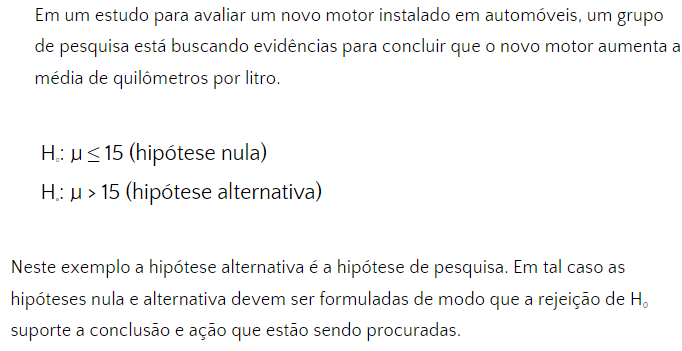
Uma hipótese estatística é uma afirmação acerca dos parâmetros de uma ou mais populações, ou acerca da distribuição da população — é uma afirmação sobre a população, não sobre a amostra.
Normalmente, formulam-se duas hipóteses:
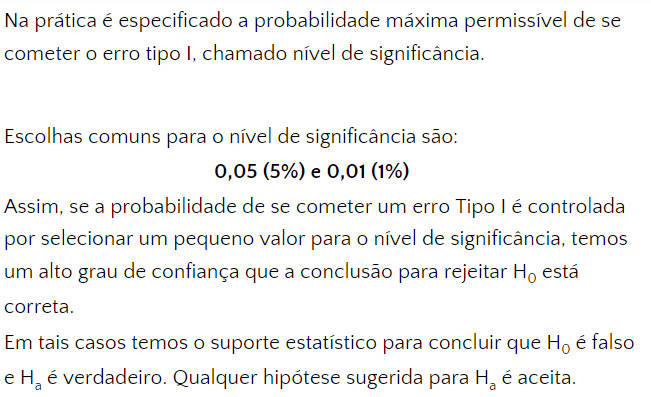
- \(H_0\) — hipótese nula, a hipótese que, a princípio, não queremos rejeitar sem evidência suficiente.
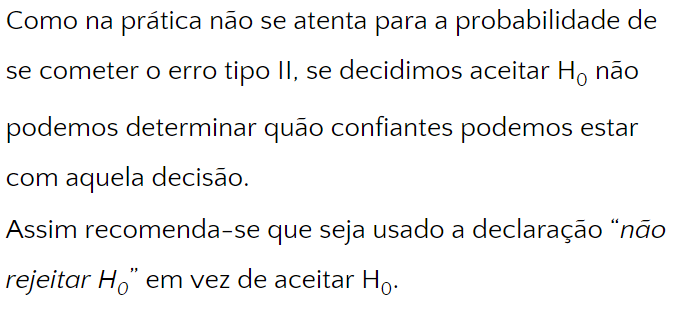
- \(H_a\) — hipótese alternativa, aceita quando não é possível sustentar \(H_0\) como verdadeira.
Example
Imagem de referência
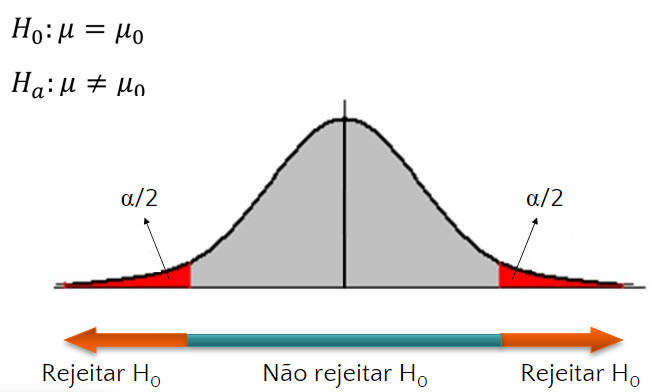
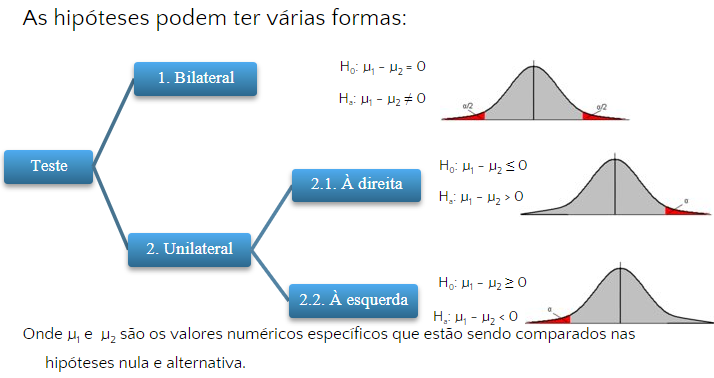
Formas de hipótese
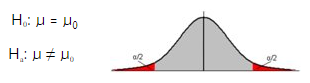
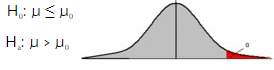
-
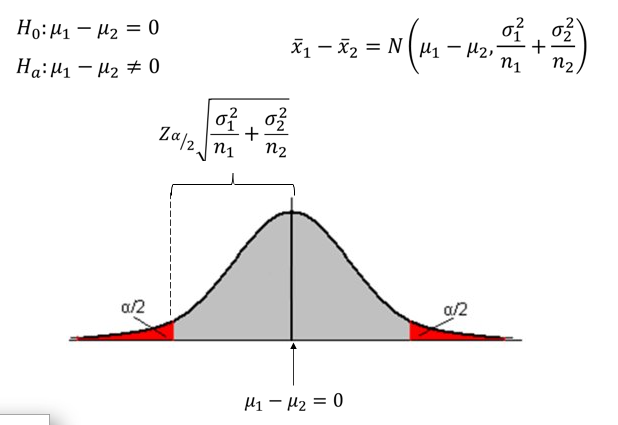
Bilateral:
Imagem de referência
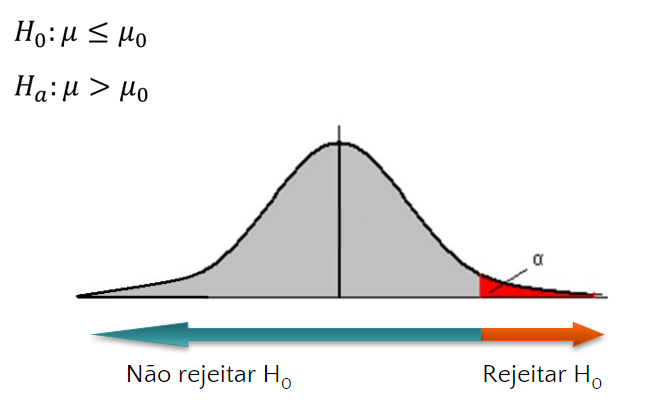
-
Unilateral à direita:
Imagem de referência
-
Unilateral à esquerda:
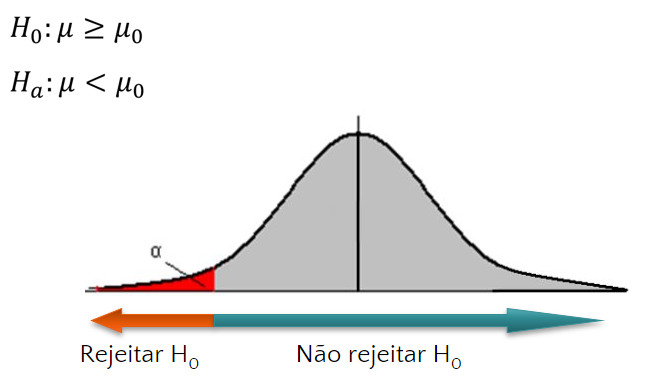
Imagem de referência
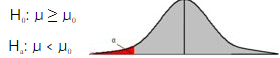
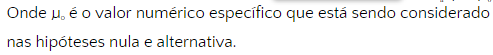
Imagem de referência
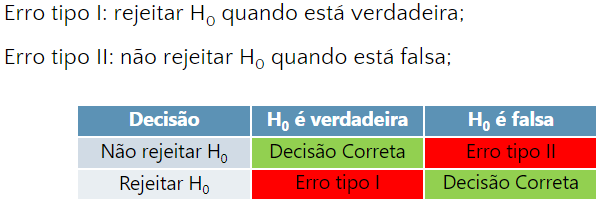
Erros de decisão
| \(H_0\) verdadeira | \(H_0\) falsa | |
|---|---|---|
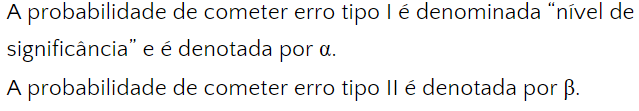
| Rejeitar \(H_0\) | Erro Tipo I (\(\alpha\)) | Decisão correta |
| Não rejeitar \(H_0\) | Decisão correta | Erro Tipo II (\(\beta\)) |
Imagens de referência
Como realizar testes de hipótese
Imagens de referência
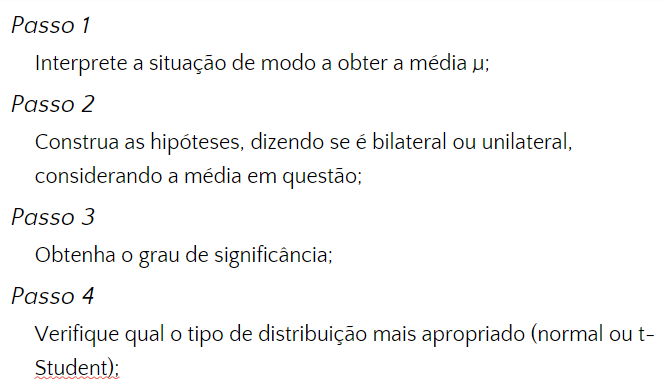
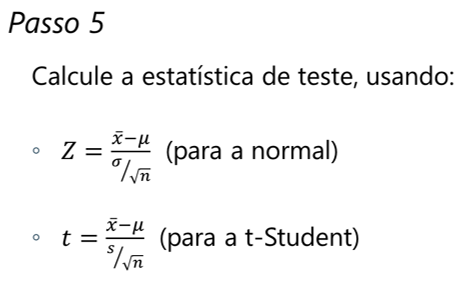
Note
Usa-se a distribuição t-Student quando a variância é desconhecida, com \(n - 1\) graus de liberdade.
Imagens de referência
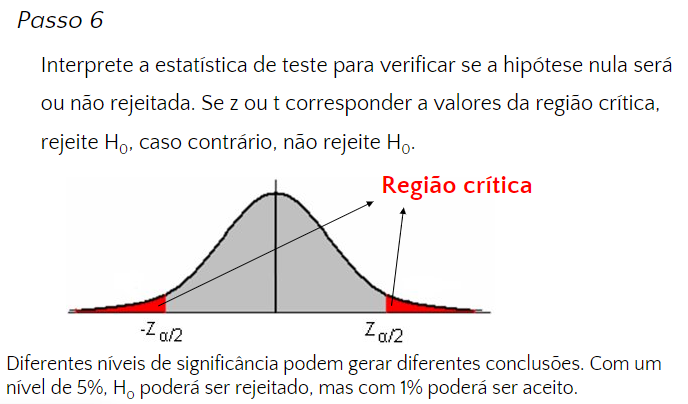
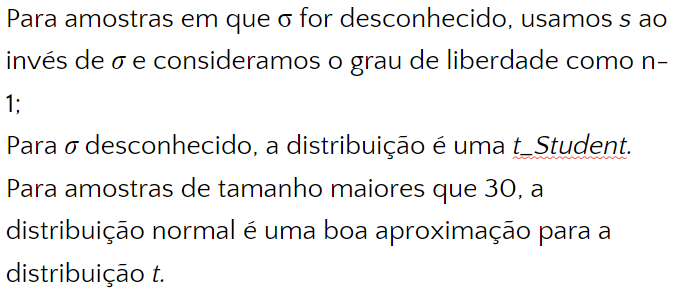
Testes de hipótese em diferentes formas
Imagem de referência
Example
Imagem de referência
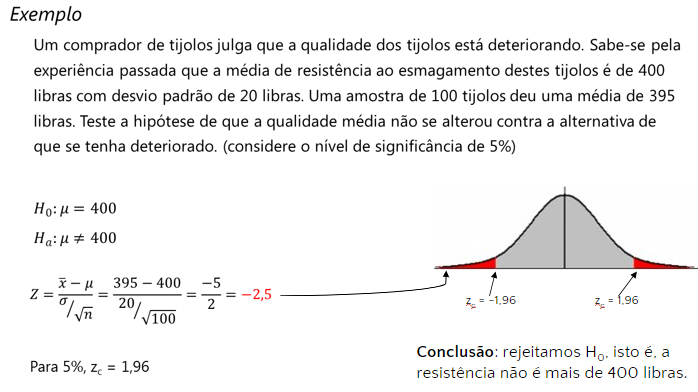
Imagem de referência
Example
Imagem de referência
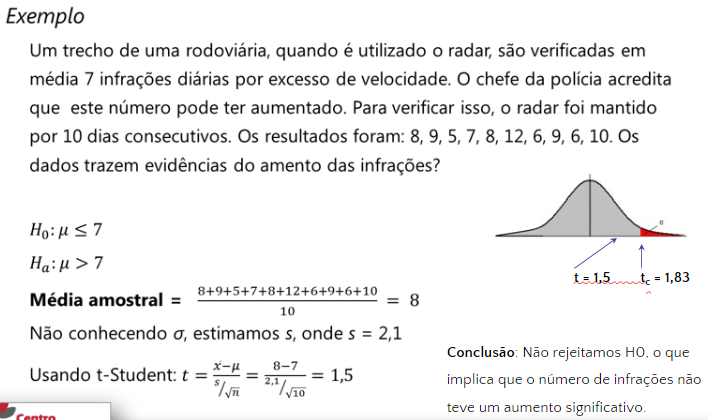
Imagem de referência
Example
Imagem de referência
Exemplos
Teste de hipóteses para duas médias
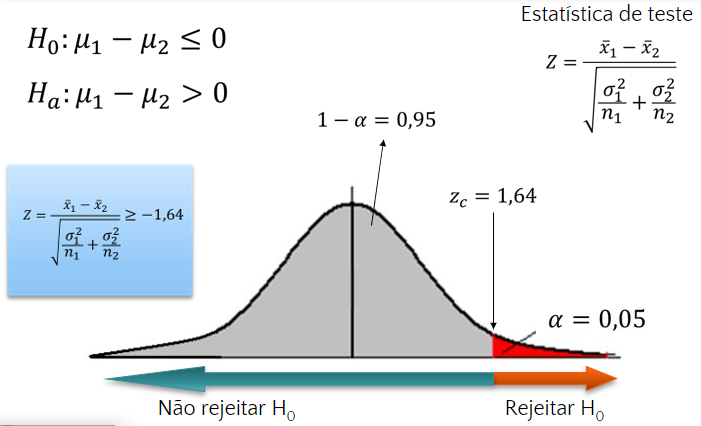
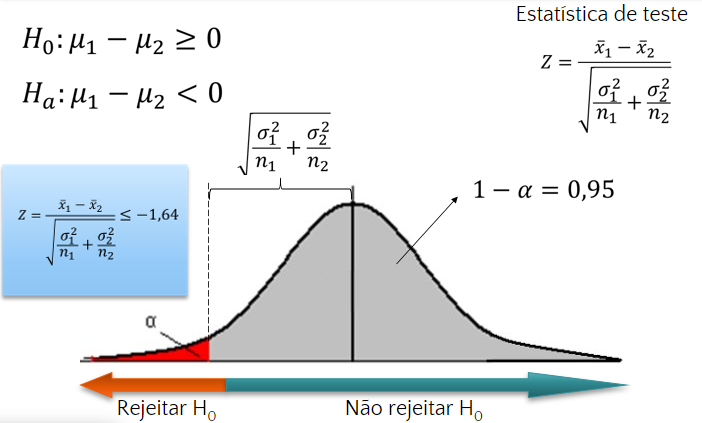
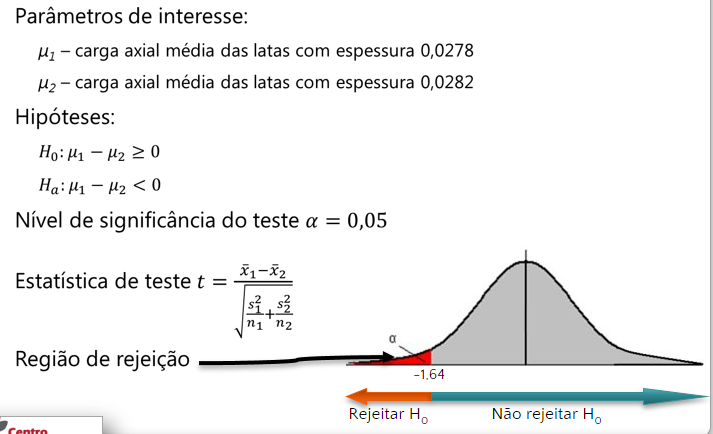
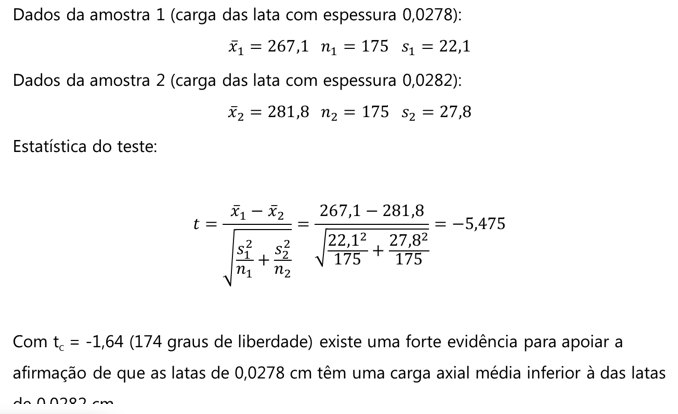
Variâncias desconhecidas — usa-se a distribuição t-Student. A estatística do teste é:
Imagem de referência
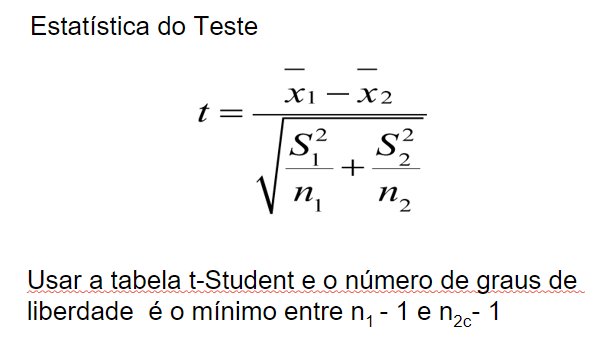
Onde \(\bar{x}_1\) e \(\bar{x}_2\) são as médias amostrais, \(n_1\) e \(n_2\) os tamanhos das amostras, e \(S_1^2\) e \(S_2^2\) as variâncias amostrais das duas populações.
O valor \(t\) calculado é comparado a um valor crítico da tabela t-Student, com \(\min\{n_1 - 1, n_2 - 1\}\) graus de liberdade (em R, usa-se qt(1 - nível_de_significância, min(n1 - 1, n2 - 1))).
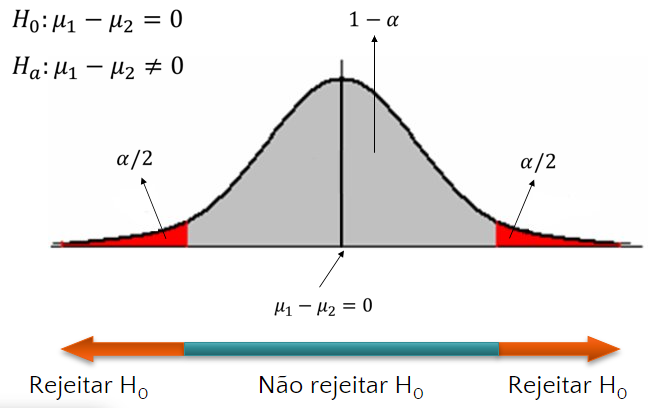
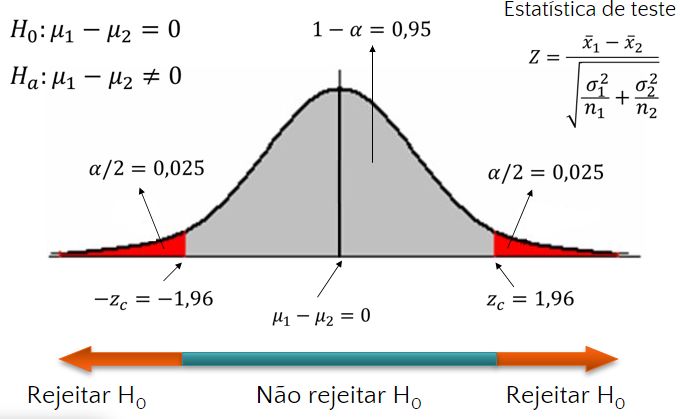
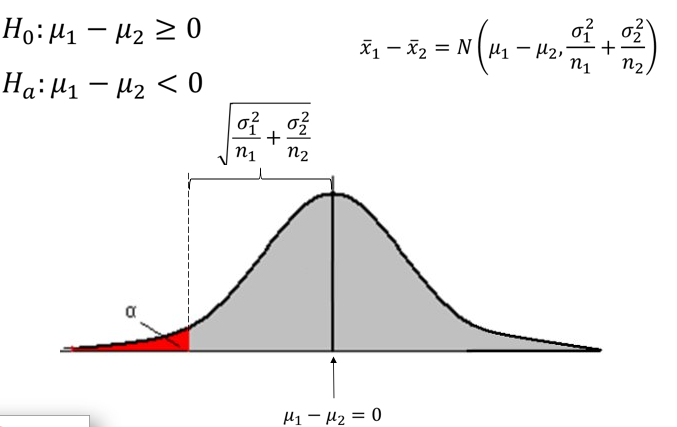
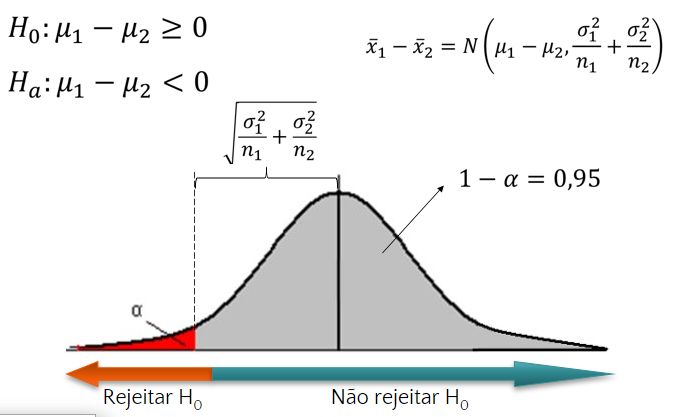
Variâncias conhecidas:
Imagem de referência
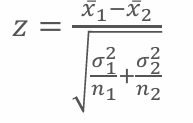
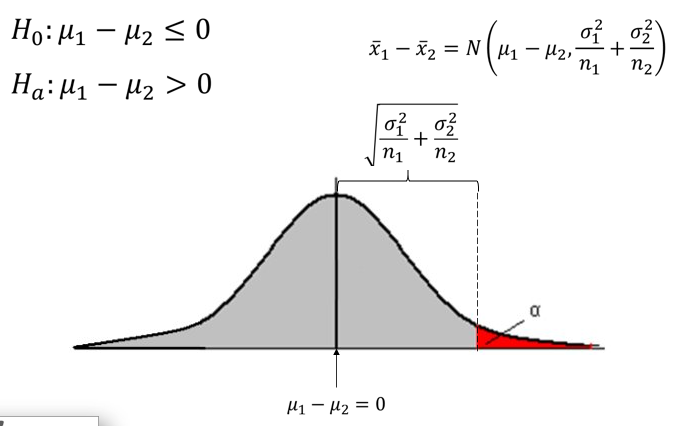
Formas
Imagem de referência
Imagens de referência
Example
Imagem de referência
Imagens de referência
Example
Imagem de referência
Imagens de referência
Example
Imagem de referência
Exemplos
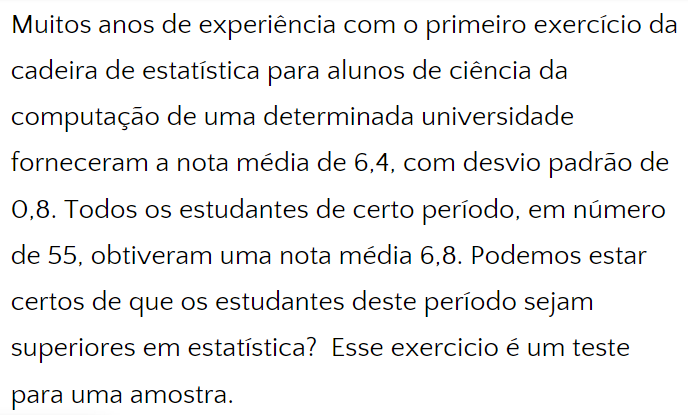
-
Imagens de referência
-
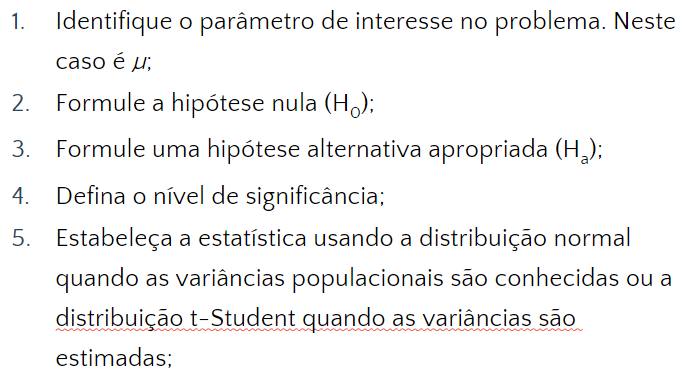
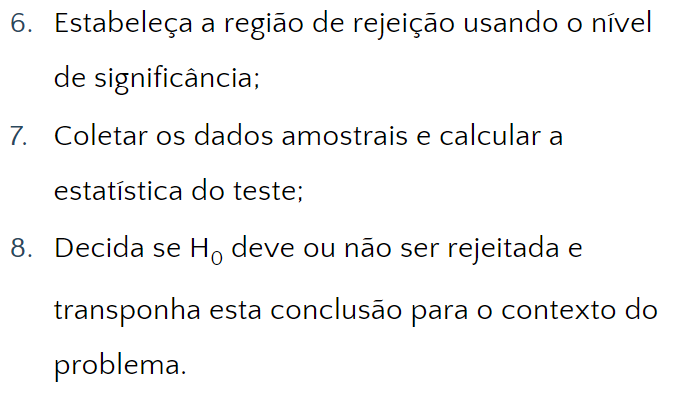
Procedimento geral para teste de hipótese
Imagem de referência
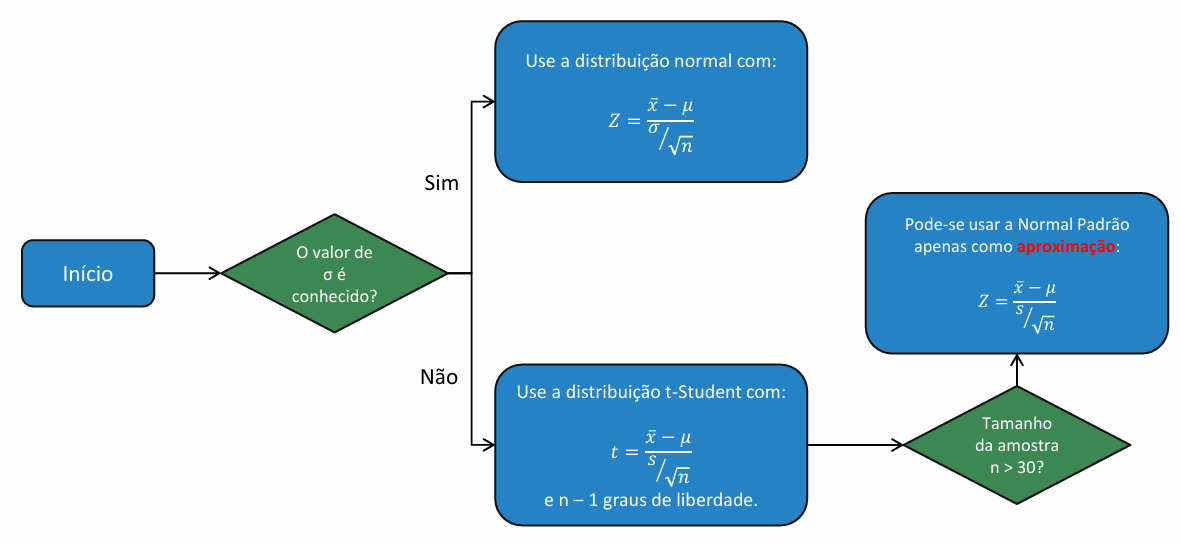
Para o 5º passo:
Imagens de referência
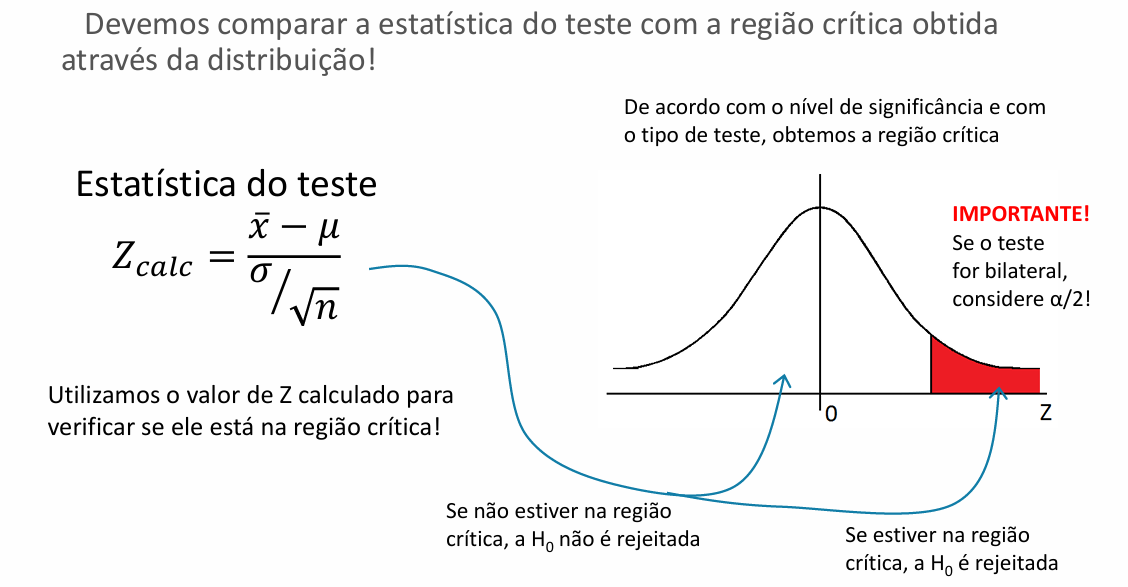
Como interpretar um teste de hipótese
Imagem de referência
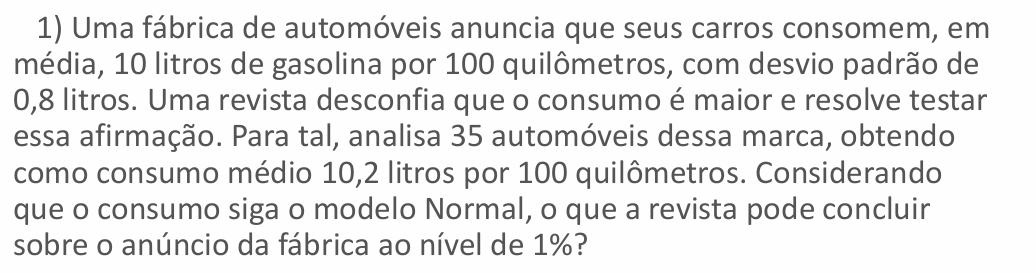
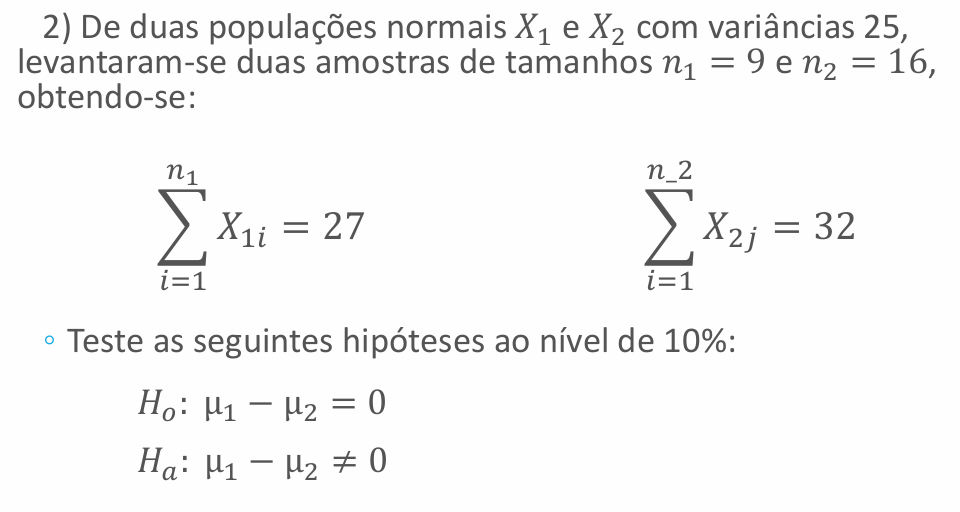
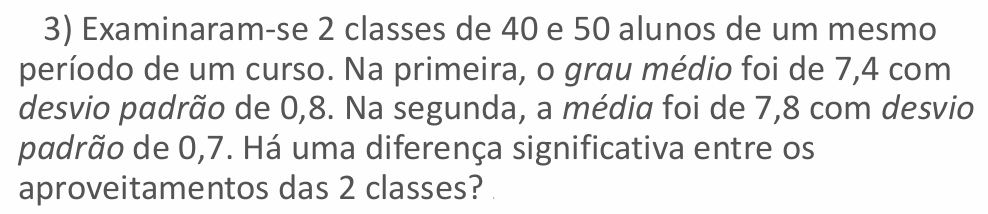
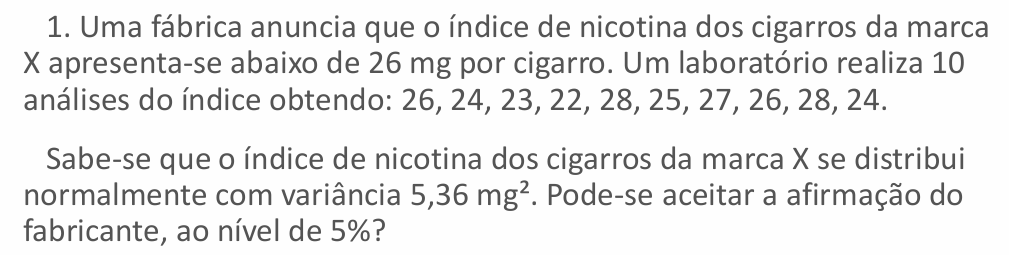
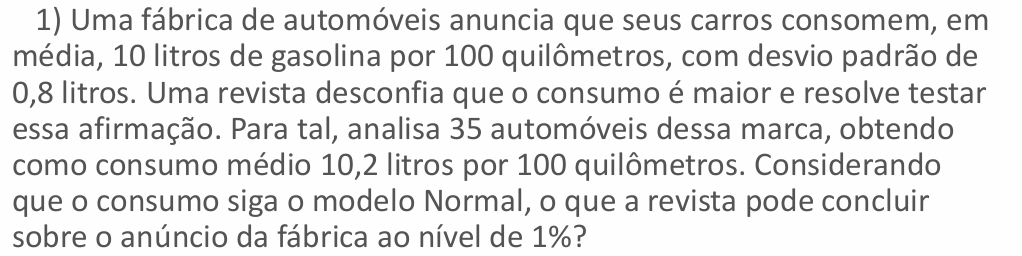
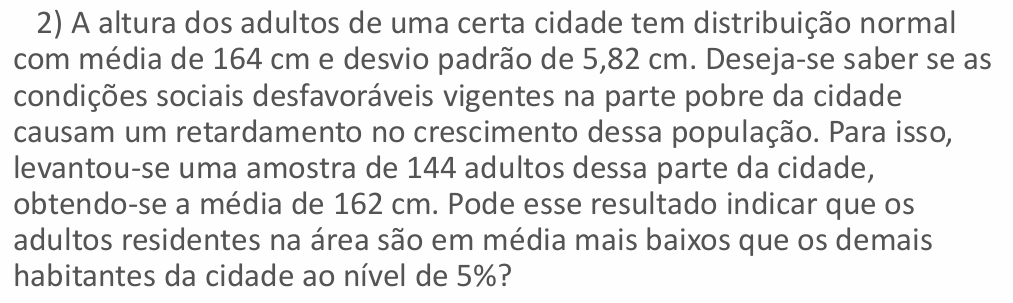
Exemplos finais
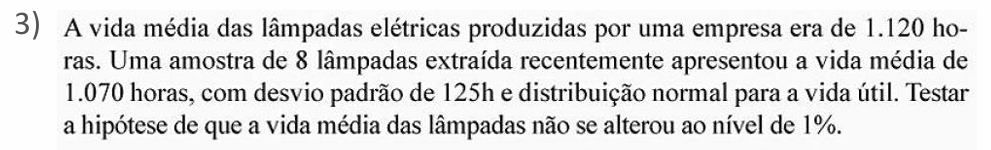
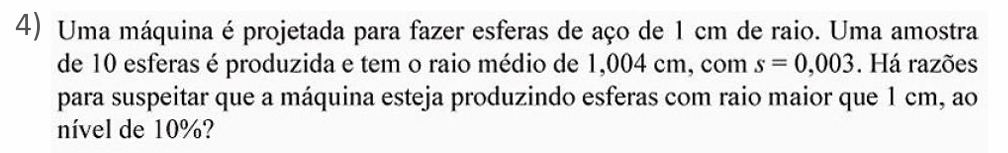
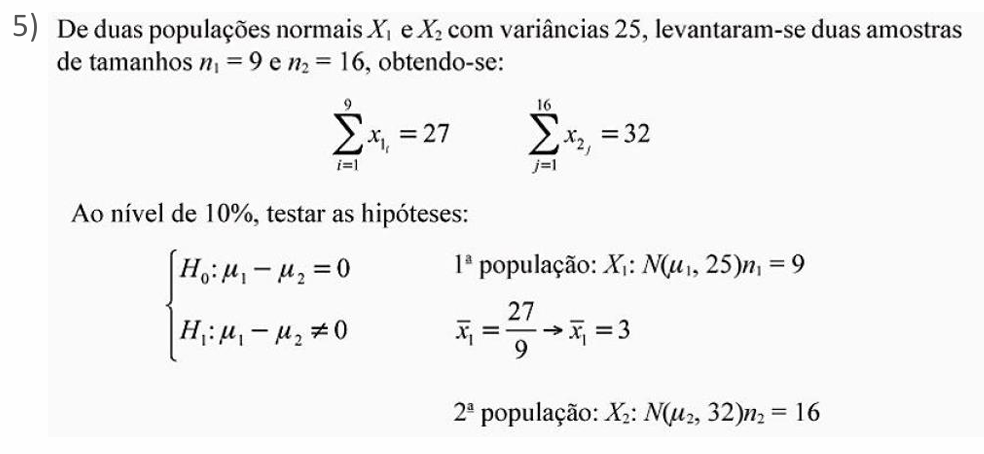
Ver também: Assunções da regressão linear